Format GGUF: Què és, com funciona i com aprofitar-ho per a models d'IA
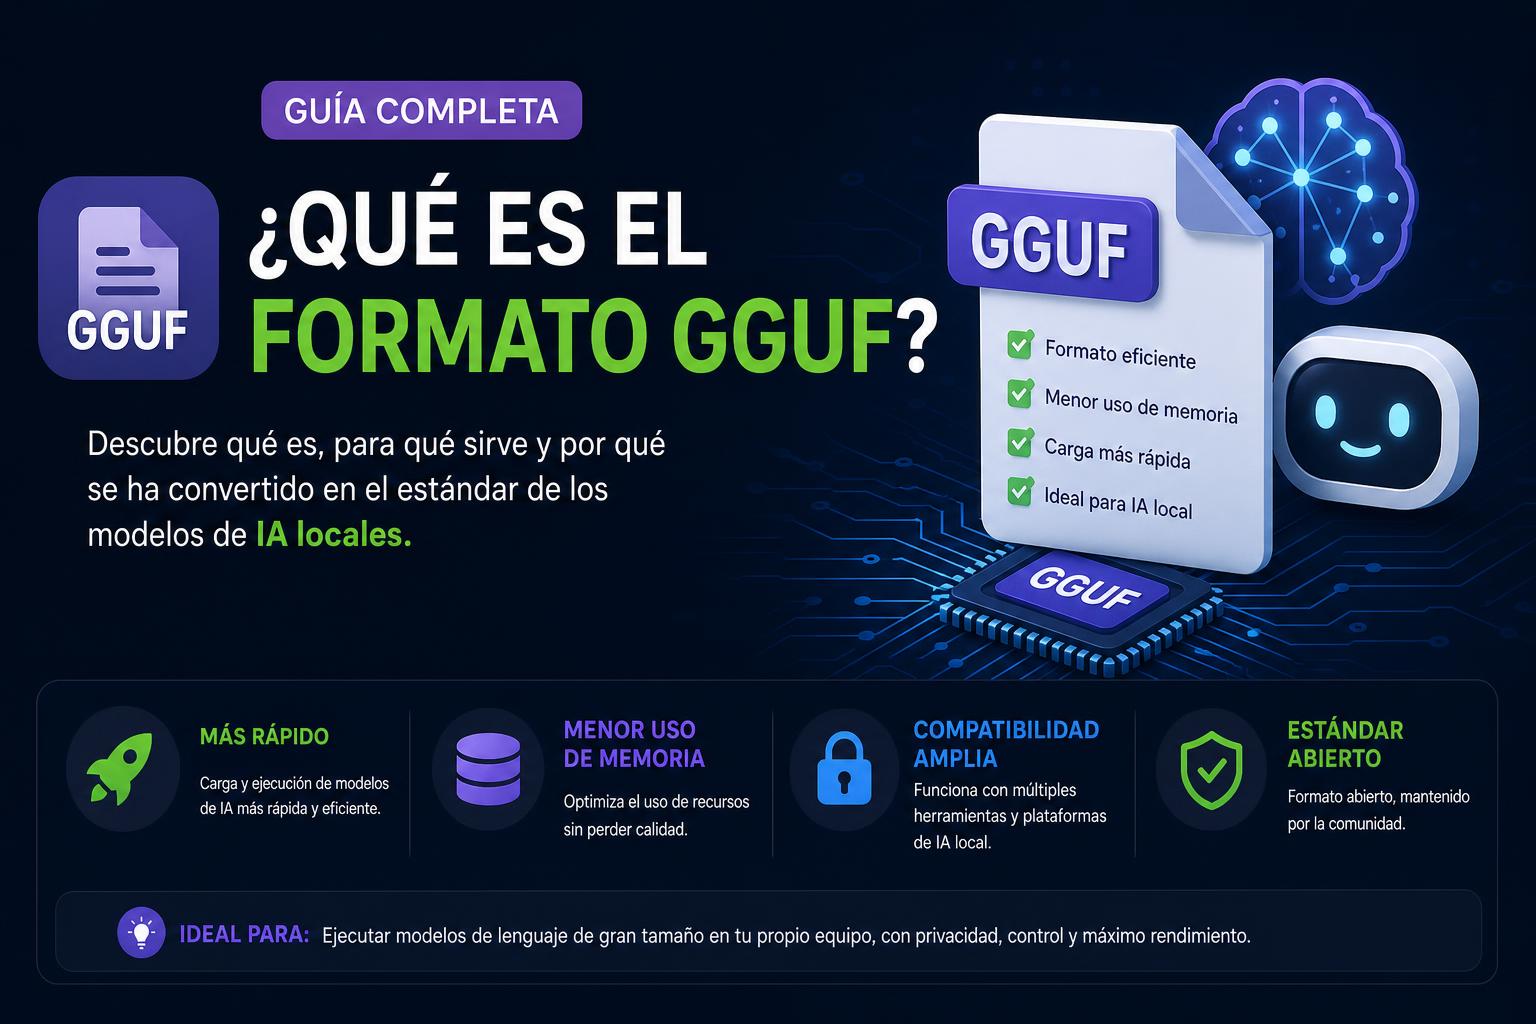
GGUF és el format de referència per compartir i executar models de IA locals, superant en flexibilitat i compatibilitat formats previs.
Els diferents nivells de quantització permeten adaptar el rendiment i el consum de recursos al maquinari de cada usuari, des d'equips modestos fins a estacions potents.
Descarregar i importar models GGUF en aplicacions com Ollama, LM Studio o AnythingLLM és senzill i permet desenvolupar solucions d'IA personalitzades fins i tot sense connexió a Internet.
La gran comunitat al voltant de GGUF, amb repositoris com Cara abraçada, facilita trobar versions actualitzades, recursos i suport per a diversos casos dús.
Has sentit a parlar darrerament dels arxius GGUF i et preguntes què són i per a què serveixen ? El món de la intel·ligència artificial avança a passos de gegant i els formats de fitxer juguen un paper crucial a l'hora d'executar models potents, tant per a professionals com per a entusiastes que volen treure el màxim profit als seus equips locals.
En aquest extens article descobrirem en profunditat tot allò relacionat amb el format GGUF: en què consisteix, per a què es va crear, com ha revolucionat l'ús de grans models de llenguatge (LLM), els seus avantatges davant de formats anteriors, els nivells de quantització, on descarregar models i com integrar-los en diferents plataformes i aplicacions d'IA.
El format GGUF (GGML Universal Format) és un fitxer binari dissenyat específicament per emmagatzemar, guardar i carregar ràpidament i eficientment models d'intel·ligència artificial de grans dimensions, principalment LLM (Models de Llenguatge com GPT, Flama, Gemma, Grok, entre d'altres) i models RAG (Retrieval Augmented Generation). GGUF sorgeix després de l'experiència prèvia amb GGML, adaptant-se a les necessitats actuals de desenvolupadors, empreses i comunitat: compatibilitat, eficiència, flexibilitat i facilitat d'integració a diferents plataformes i aplicacions.
GGUF ha estat desenvolupat com el successor natural del format GGML , aportant notables millores que responen a la creixent demanda de maquinari menys especialitzat, garantint que els grans models de IA puguin ser utilitzats no només en potents servidors o núvols, sinó fins i tot en ordinadors de sobretaula, portàtils i fins i tot alguns dispositius mòbils amb recursos limitats.
Diferències i avantatges respecte a GGML i altres formats
Si bé GGML ja va suposar un gran avenç davant de models tradicionals, GGUF eleva encara més el llistó en diversos aspectes clau. Vegem les diferències i millores principals:
Extensibilitat i futur assegurat: GGUF està pensat per incorporar noves funcionalitats, opcions de metadades o paràmetres que puguin requerir futurs models, sense perdre compatibilitat cap enrere. Això facilita que tant nous desenvolupaments com eines existents puguin beneficiar-se de millores sense haver de refer-ho tot des de zero.
Flexibilitat a l'estructura: Permet organitzar les dades del model de manera més eficient, adaptant-se a diferents arquitectures i frameworks, especialment per a models de IA emergents o experimentals.
Interoperabilitat i compatibilitat: GGUF s'ha dissenyat per poder ser usat sense problemes en una amplíssima gamma d'entorns: des d'aplicacions de Python o R fins a motors com truca.cpp, Ollama, AnythingLLM o LM Studio. Això fa que els usuaris puguin compartir, descarregar i importar models sense preocupar-se per incompatibilitats o canvis als fluxos de treball.
Grandària optimitzada i rapidesa de càrrega: Gràcies a diversos nivells de compressió i quantització, els fitxers GGUF aconsegueixen que els models siguin molt més lleugers i ràpids de carregar, estalviant memòria i accelerant la inferència (resposta del model en temps real).
Suport actiu i comunitat: Com que és un estàndard obert i en constant evolució, hi ha una gran comunitat participant tant en el desenvolupament del format com en la creació i testeig de noves versions de models optimitzades i documentades.
Per què serveix GGUF i què et permet fer?
El format GGUF serveix principalment per emmagatzemar models de IA en un format compacte, portàtil i molt eficient, preparat específicament per a la seva execució local. D'aquesta manera, pots descarregar models d'última generació entrenats prèviament (com GPT, Gemma, Flama, Grok, Mistral, etc.) i executar-los al teu propi ordinador, sense dependre de serveis al núvol, sense enviar dades personals a altres companyies i amb respostes en temps real adaptades a les teves necessitats.
Aquesta capacitat resulta especialment útil per a:
Desenvolupadors d'aplicacions de chatbots IA, assistents personals, motors de cerca intel·ligents o tasques d'anàlisi i processament de text avançat.
Professionals que requereixen privacitat absoluta en els processos d'IA, atesa la naturalesa local dels models GGUF.
Persones que volen optimitzar costos i recursos, evitant el pagament recurrent per APIs externes o serveis en línia.
Empreses i particulars interessats a experimentar, fer fine-tuning (ajust fi personalitzat) o treballar amb models IA de forma offline.
Entorns educatius i de recerca on compartir models i ajustaments entre usuaris de diferents plataformes és prioritari.
D'on ha sortit GGUF i com es diferencia de formats com ara PyTorch, Safetensors, GPTQ, etc.?
La família de formats per a models d'IA és molt variada , però cadascun respon a necessitats i limitacions diferents:
PyTorch (.pth, .pt, binaris, safetensors…): S'utilitzen habitualment durant l'entrenament o durant el fine tuning en entorns de desenvolupament, i solen requerir maquinari potent només per a GPU. A més, inclouen gran quantitat de metadades i codi, cosa que augmenta la seva mida i complexitat.
GGML: Va néixer com a resposta per facilitar la inferència local, però ha estat ràpidament superat per GGUF gràcies a les millores ja esmentades.
GGUF: Neix per cobrir la portabilitat, compatibilitat i la possibilitat de fàcil actualització juntament amb esquemes de quantització moderns.
GPTQ, AWQ, EXL2, QLoRA, LoRA…: Són mètodes de quantització i ajustament fi que permeten reduir dràsticament el pes (mida) del model, ajustant la precisió i aprofitant recursos com GPUs o CPUs de forma òptima. Molts models GGUF estan quantitzats sota aquests mètodes.
En resum, que és el format GGUF és el format pensat no només per a la inferència local, sinó també per compartir models llestos per utilitzar-los en una gran varietat d'eines i plataformes, independentment del sistema operatiu o l'arquitectura.
Quantització a GGUF: Què significa i com afecta el model?
Des de l'auge dels models LLM, el concepte de quantització s'ha tornat clau: consisteix a reduir la precisió (bits) dels “pesos” o paràmetres interns del model IA durant el desament o exportació, canviant, per exemple, de formats de 16 bits (FP16) o fins i tot 32 bits a representacions molt més lleugeres. Això significa que el model ocupa molt menys espai, necessita menys memòria RAM i calcula molt més ràpid , a canvi duna lleugera pèrdua de precisió en les respostes.
El format GGUF porta aquesta flexibilitat extrema a la seva màxima expressió: inclou “quantitzacions” de diversos nivells i és compatible tant amb enfocaments tradicionals (per assolir màxima qualitat) com amb nivells ultra comprimits ajustats a maquinari limitat.
Principals esquemes de quantització a GGUF
Q4_K_M (o variants Q4…): L'equilibri ideal per a la majoria d'usuaris: ocupa poc, és ràpid i la qualitat és gairebé idèntica al model original en tasques quotidianes (Q&A, programació, redacció, resums, etc.). Sol ser el valor per defecte recomanat.
Q5_K_M: Recomanat quan busques millor qualitat i el teu maquinari disposa de suficient VRAM (memòria gràfica). Notaràs millors resultats en tasques de raonament complex, matemàtiques avançades i contextos exigents.
Q8_0: La representació amb màxima qualitat compatible (gairebé igual als originals sense comprimir). Només recomanable si pots assumir la gran mida del fitxer i tens molta memòria RAM/VRAM.
IQ4_XS: El format més petit i lleuger que encara és utilitzable. Perfecte per a proves, experimentació ràpida o dispositius amb molt poca VRAM.
Evita Q3 i Q2 si busques qualitat: La pèrdua de precisió sol ser molt notable i només són útils en entorns molt restringits o per a tasques concretes.
Nivells de quantització: comparació i casos dús
Quin nivell triar? Aquí és on el format GGUF brilla per la seva versatilitat. Segons les necessitats, pots triar:
Quantització de 2 bits: Grandària mínima, màxima compressió. Usat en dispositius molt limitats, però la pèrdua de qualitat pot ser elevada.
Quantització de 4 bits: Compressió i velocitat molt superiors sense gairebé perdre qualitat per a tasques comunes. Solució preferida per a molts desenvolupadors.
Quantització de 8 bits: Gairebé la màxima fidelitat i amb prou feines compressió comparada amb els originals sense processar.
En combinar-ho amb els diferents mètodes (GPTQ, AWQ, QLoRA, etc.), GGUF permet desplegar el mateix model amb diferents “sabors”, adaptant-se a cada cas d'ús i maquinari disponible.
Quins avantatges pràctics ofereix GGUF a usuaris i empreses?
Càrrega ultraràpida: Gràcies al seu format binari i estructura eficient, és possible carregar models en segons, important per a aplicacions i serveis sensibles alhora o amb actualització freqüent.
Portabilitat i estandardització: Compartir, copiar i instal·lar models GGUF és tan fàcil com moure un únic fitxer, sense embolics de dependències ni versions.
compatibilitat: S'integra amb una enorme varietat de frameworks (Python, R, CUDA, etc.) i aplicacions (des d'Ollama fins a AnythingLLM, LM Studio o chatbots personalitzats).
Consum energètic reduït: Els models quantitzats de GGUF, en necessitar menys recursos, ajuden a reduir la factura elèctrica i la petjada de carboni del maquinari, facilitant a més el seu ús en dispositius edge o solucions mòbils.
Actualització i escalabilitat: Incorporar nous tipus de dades o paràmetres és trivial, per la qual cosa GGUF està preparat per als futurs avenços del sector IA.
On descarregar arxius GGUF i com integrar-los als teus projectes?
La font principal i més famosa de models GGUF és la secció d'Arxius GGUF a Hugging Face . Allí pots filtrar, buscar i descarregar gratuïtament milers de models LLM i variants RAG quantitzats en diferents nivells, ja llestos per fer servir en local.
A més de Hugging Face, algunes aplicacions permeten descarregar models des de les seves pròpies interfícies o fins i tot transferir-los i gestionar-los des de directoris locals, exportant o important altres apps (com LM Studio, AnythingLLM o Chatbox).
Com importar un fitxer GGUF descarregat a Ollama
Descarrega el model GGUF: Trieu el nivell de quantització que millor s'adapti al vostre maquinari i deseu-lo en una carpeta local.
Crea un fitxer Modelfile: Al mateix directori, crea un fitxer (per exemple, “Modelfile”) amb una línia FROM apuntant al nom real del teu fitxer .gguf. Això indica a Ollama d'on heu de carregar el model.
Carrega el model a Ollama: Executeu l'ordre adequada per importar el model usant l'opció “-f Modelfile”. Exemple: ollama create myModelName -f Modelfile
Executa el model: Ja pots fer ús del model local com si ho haguessis descarregat des de la llibreria estàndard.
Aquest procés és molt semblant per a LM Studio, AnythingLLM i altres aplicacions compatibles amb GGUF.
D'altra banda, si ja hi ha versions oficials del model a la biblioteca de la teva plataforma, és encara més senzill utilitzar la comanda “pull” corresponent, però la importació manual és clau si necessites una variant específica de quantització, un model poc habitual o si prefereixes més control sobre on i com s'emmagatzema el model.
Aplicacions compatibles i principals usos reals dels fitxers GGUF
Actualment, l' ecosistema GGUF és amplíssim. Fes una ullada als principals projectes i contextos d'ús:
Ollama: Permet importar models externs, crear els teus propis i experimentar amb ajustaments de quantització i templates personalitzats.
Estudi LM: Inclou una interfície gràfica molt senzilla per buscar, descarregar i instal·lar models GGUF, a més d'exportar-los a altres apps o consultar-los via API local.
AnythingLLM y gen: Solucions d'escriptori i empresarials per fer servir chatbots IA locals, amb suport total per a models GGUF i plantilles pre-entrenades.
3DIMLI: Glossaris tècnics i botigues que ofereixen models o materials específics a GGUF, amb recomanacions sobre com documentar correctament versions i compatibilitats per a cada cas.
Projectes open source i entorns de recerca gràcies a la interoperabilitat amb Python i R.
A més, diverses plataformes professionals i comercials comencen a oferir models llestos a GGUF per accelerar el deployment i integració de solucions avançades d'IA.
Cures i consells pràctics en treballar amb arxius GGUF
Verifica sempre la compatibilitat: Abans de descarregar qualsevol fitxer GGUF, revisa que sigui compatible amb la teva aplicació (versió concreta d'Ollama, LM Studio, etc.) i el teu maquinari. Si el model requereix una versió de motor concreta, verifica aquesta nota a la web d'origen.
Anomena i organitza amb cura els fitxers: Atès que alguns processos diferencien entre majúscules, minúscules o fins i tot espais, utilitza noms simples i clars per evitar errors a la càrrega.
Adequa la quantització al teu equip: Encara que puguis importar models Q8 o Q5, si el teu VRAM és limitada és millor optar per Q4 o IQ4, i així evitar bloquejos per manca de recursos.
Personalitza plantilles si crees chatbots: En importar models de xat, pot ser necessari ajustar la plantilla (prompt template) al Modelfile o configuració per aconseguir respostes més estables i naturals.
Atenció a llicències i drets: Alguns models GGUF afegeixen restriccions dús. Consulta la pàgina de descàrrega per comprovar si els pots utilitzar amb finalitats comercials o per redistribució.
Recomanacions per triar el model i la quantització idònia
Tal com han comprovat experts i usuaris, hi ha una clara guia pràctica a seguir:
Per a tasques del dia a dia (xatejar, programar, redacció, consultes generals): tria Q4_K_M. És l'autèntic “punt dolç” en qualitat/rendiment i està suportat per gairebé tots els frameworks.
Per a treball avançat o matemàtiques complexes: Si tens prou memòria, puja a Q5_K_M, però normalment la diferència en qualitat només serà notòria en tasques exigents.
Hardware top? Si heu invertit en una GPU gran i us interessa la màxima fidelitat, podeu provar Q8_0, però el salt davant Q5 no sempre es justifica excepte en benchmarking o investigació.
Recursos limitats? Prova IQ4_XS per a proves, prototips ràpids o quan vagis ajustadíssim de RAM/VRAM.
Evita Q3/Q2 per a entorns reals o professionals, ja que “pateix” en coherència i precisió de resultats.
Com contribueix GGUF al desenvolupament i futur de la IA local i open source
El format GGUF no només accelera l'adopció d'IA en dispositius personals, sinó que democratitza l'accés a models avançats . Permet a més persones i empreses:
Provar de primera mà els darrers avenços en IA generativa sense haver de dependre de grans corporacions
Personalitzar models, afegir funcions i compartir versions ajustades a comunitats o grups de recerca
Experimentar amb diferents arquitectures, paràmetres i escalabilitat sense por a incompatibilitats o bloquejos
GGUF fomenta a més l'aparició de noves eines, traductors i motors, i garanteix que els desenvolupaments actuals continuaran sent útils anys després gràcies al seu enfocament extensible. La interoperabilitat i la facilitat per documentar-lo, agrupar-lo i exportar-lo fa que sigui un format de referència, tant a repositoris com a botigues, glossaris tècnics i projectes oberts de la comunitat.
Quins reptes i oportunitats hi ha per al futur de GGUF?
Si bé el format GGUF ja és una referència, la comunitat continua debatent i afegint millores com:
Optimització per a noves arquitectures de maquinari (SoC mòbils, edge devices, FPGA, etc.)
Desenvolupament de millors convertidors entre frameworks, per exemple des de PyTorch o TensorFlow directament a GGUF
Major automatització en l'ajust de plantilles i prompts per a models de xat o tasques específiques
Integració avançada amb eines de quantització, millores en els sistemes de documentació i descobriment de models
Tot això suposarà que descarregar, personalitzar i integrar models de IA avançats serà cada cop més fàcil, ràpid i assequible , tant per a pimes, investigadors, entusiastes o grans plataformes.
El format GGUF s'ha consolidat com la millor solució per executar intel·ligència artificial local i controlada, aprofitant molt bé els recursos del teu ordinador, ja sigui d'última generació o més modest, i integrant de manera senzilla els darrers models LLM del mercat. Amb la quantitat de recursos, tutorials i aplicacions compatibles que existeixen, és qüestió de minuts trobar, importar i començar a fer servir models llestos, optimitzant tant de temps com costos i gaudint de la màxima privadesa i escalabilitat. GGUF és clau en l'obertura, la democratització i el futur de la intel·ligència artificial pràctica.