Hjem » Kunstig intelligens » GGUF-format: Hvad det er, hvordan det fungerer, og hvordan man udnytter det til AI-modeller
GGUF-format: Hvad det er, hvordan det fungerer, og hvordan man udnytter det til AI-modeller
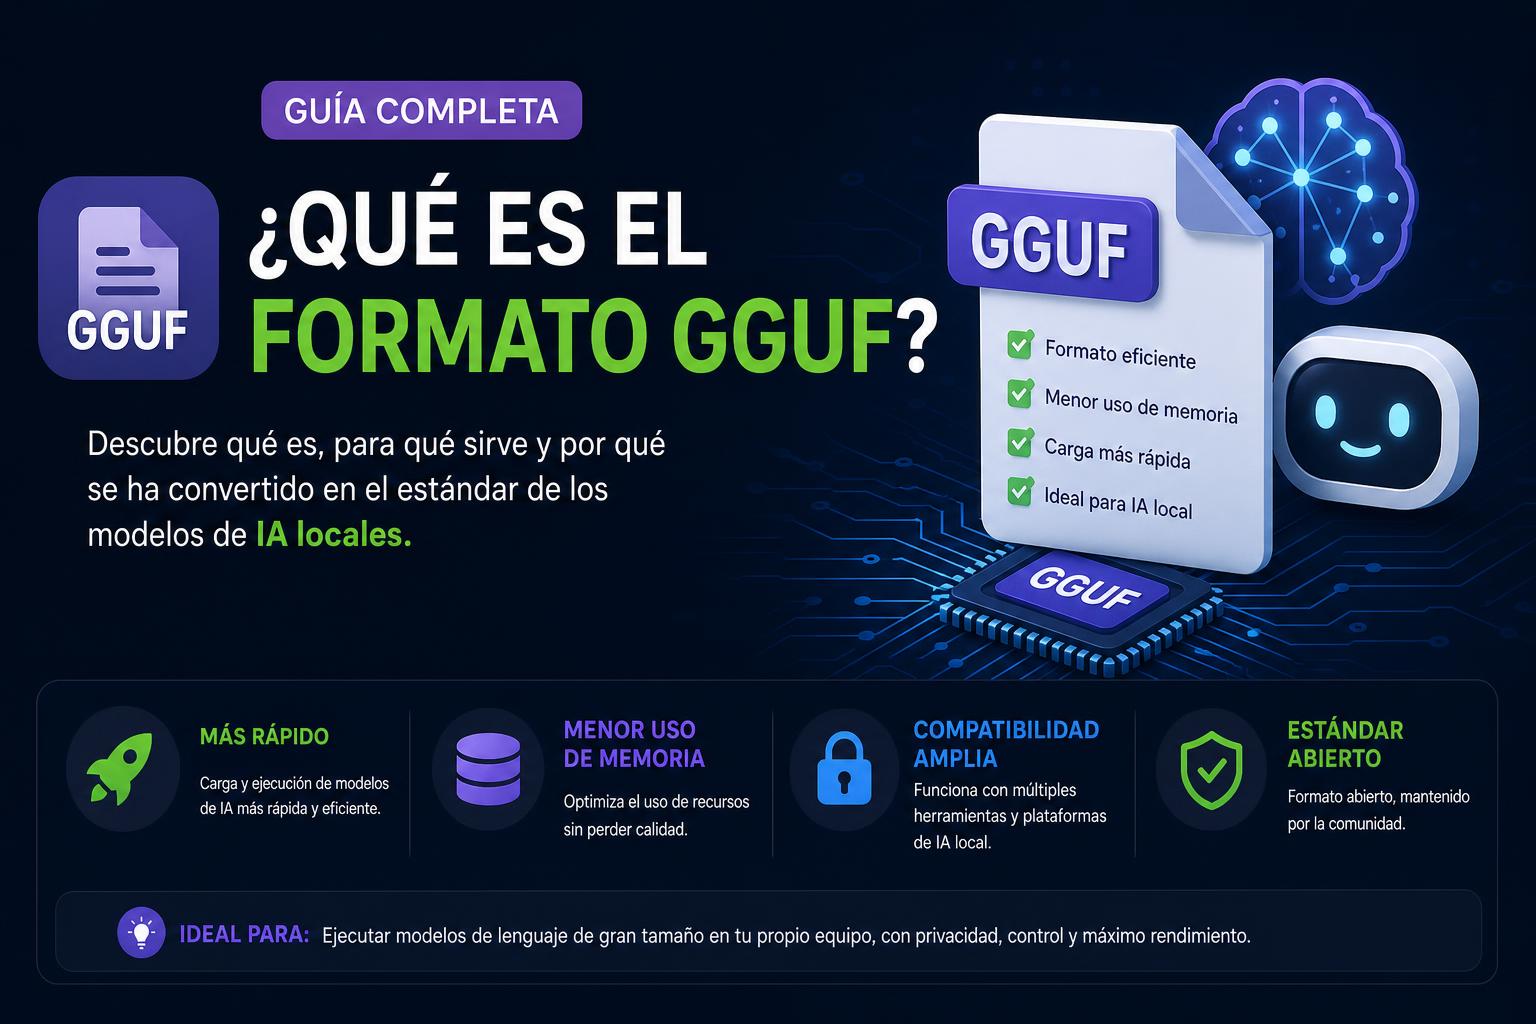
GGUF er referenceformatet til deling og kørsel af lokale AI-modeller, der overgår tidligere formater i fleksibilitet og kompatibilitet.
Dens forskellige kvantiseringsniveauer gør det muligt at tilpasse ydeevne og ressourceforbrug til hver brugers hardware, fra beskedent udstyr til kraftfulde arbejdsstationer.
Det er nemt at downloade og importere GGUF-modeller til applikationer som Ollama, LM Studio eller AnythingLLM, og det giver dig mulighed for at udvikle brugerdefinerede AI-løsninger, selv uden en internetforbindelse.
Det store fællesskab omkring GGUF, med arkiver som Knusende ansigtDet gør det nemt at finde opdaterede versioner, ressourcer og support til forskellige anvendelsesscenarier.
Har du hørt om GGUF-filer for nylig og spekuleret på, hvad de er, og hvad de bruges til ? Verdenen af kunstig intelligens udvikler sig med stormskridt, og filformater spiller en afgørende rolle i at køre kraftfulde modeller, både for professionelle og entusiaster, der ønsker at få mest muligt ud af deres lokale udstyr.
I denne omfattende artikel vil vi udforske alt, der har med GGUF-formatet at gøre: hvad det er, hvad det blev skabt til, hvordan det har revolutioneret brugen af store sprogmodeller (LLM), dets fordele i forhold til tidligere formater, kvantiseringsniveauerne, hvor man kan downloade modeller, og hvordan man integrerer dem i forskellige AI-platforme og -applikationer.
GGUF (GGML Universal Format) er en binær fil , der er specielt designet til hurtigt og effektivt at gemme, gemme og indlæse store kunstig intelligens-modeller, primært LLM (Language Models such as GPT, Llama, Gemma, Grok, m.fl.) og RAG (Retrieval Augmented Generation) modeller . GGUF er opstået fra tidligere erfaringer med GGML og tilpasser sig de nuværende behov hos udviklere, virksomheder og fællesskabet: kompatibilitet, effektivitet, fleksibilitet og nem integration på tværs af forskellige platforme og applikationer.
GGUF er blevet udviklet som den naturlige efterfølger til GGML-formatet og har medført bemærkelsesværdige forbedringer, der imødekommer den stigende efterspørgsel efter mindre specialiseret hardware. Dette sikrer, at store AI-modeller ikke kun kan bruges på kraftfulde servere eller cloud-løsninger, men også på stationære computere, bærbare computere og endda nogle mobile enheder med begrænsede ressourcer.
Forskelle og fordele sammenlignet med GGML og andre formater
Selvom GGML allerede var en betydelig forbedring i forhold til traditionelle modeller, hæver GGUF barren yderligere på flere vigtige områder. Lad os se på de vigtigste forskelle og forbedringer:
Udvidelsesmuligheder og en sikker fremtid: GGUF er designet til at inkorporere nye funktionaliteter, metadatamuligheder eller parametre, som fremtidige modeller måtte kræve, uden at miste bagudkompatibilitet. Dette gør det nemmere for både nye udviklinger og eksisterende værktøjer at drage fordel af forbedringer uden at skulle lave alt om fra bunden.
Fleksibilitet i struktur: Det giver dig mulighed for at organisere modeldata mere effektivt og tilpasse dig forskellige arkitekturer og frameworks, især til nye eller eksperimentelle AI-modeller.
Interoperabilitet og kompatibilitet: GGUF er designet til problemfri brug i en bred vifte af miljøer: fra Python- eller R-applikationer til programmer som llama.cpp, Ollama, AnythingLLM eller LM Studio. Dette giver brugerne mulighed for at dele, downloade og importere modeller uden at bekymre sig om inkompatibiliteter eller ændringer i arbejdsgange..
Optimeret størrelse og hurtig indlæsning: Takket være forskellige niveauer af komprimering og kvantisering gør GGUF-filer modeller meget lettere og hurtigere at indlæse. sparer hukommelse og fremskynder inferens (modelrespons i realtid).
Aktiv støtte og fællesskab: Som en åben og konstant udviklende standard deltager et stort fællesskab både i udviklingen af formatet og i oprettelsen og testningen af nye, optimerede og dokumenterede versioner af modeller.
Hvad bruges GGUF til, og hvad giver det dig mulighed for?
GGUF-formatet bruges primært til at gemme AI-modeller i et kompakt, bærbart og yderst effektivt format, der er specielt designet til lokal udførelse. Dette giver dig mulighed for at downloade præ-trænede, avancerede modeller (såsom GPT, Gemma, Llama, Grok, Mistral osv.) og køre dem på din egen computer uden at være afhængig af cloud-tjenester, uden at sende personlige data til andre virksomheder og med realtidsresponser, der er skræddersyet til dine behov.
Denne funktion er især nyttig til:
Udviklere af AI-chatbot-applikationer, personlige assistenter, intelligente søgemaskiner eller avancerede tekstbehandlings- og analyseopgaver.
Fagfolk, der har brug for Privacy absolut i sine AI-processer, givet GGUF-modellernes lokale karakter.
Folk, der ønsker at optimere omkostninger og ressourcer og undgå tilbagevendende betalinger for eksterne API'er eller onlinetjenester.
Virksomheder og enkeltpersoner, der er interesserede i at eksperimentere, finjustere eller arbejde med AI-modeller offline.
Uddannelses- og forskningsmiljøer, hvor deling af modeller og justeringer mellem brugere af forskellige platforme er en prioritet.
Hvor stammer GGUF fra, og hvordan adskiller det sig fra formater som PyTorch, Safetensors, GPTQ osv.?
Familien af formater til AI-modeller er meget varieret , men hver enkelt imødekommer forskellige behov og begrænsninger:
PyTorch (.pth, .pt, binære filer, safetensorer…): De bruges almindeligvis under træning eller finjustering i udviklingsmiljøer og kræver normalt kraftig hardware, der kun kræver GPU'er. Derudover indeholder de en stor mængde metadata og kode, hvilket øger deres størrelse og kompleksitet..
GGML: Det blev oprettet som et svar for at lette lokal inferens, men er hurtigt blevet overgået af GGUF takket være de førnævnte forbedringer.
GGUF: Den blev skabt for at dække portabilitet, kompatibilitet og muligheden for nem opdatering sammen med moderne kvantiseringsordninger.
GPTQ, AWQ, EXL2, QLoRA, LoRA...: Dens kvantiserings- og finjusteringsmetoder Disse metoder muliggør en drastisk reduktion af modellens størrelse, samtidig med at nøjagtigheden justeres og ressourcer som GPU'er eller CPU'er udnyttes optimalt. Mange GGUF-modeller kvantiseres ved hjælp af disse metoder.
Kort sagt er GGUF-formatet ikke kun designet til lokal inferens, men også til deling af modeller, der er klar til brug på tværs af en bred vifte af værktøjer og platforme, uanset operativsystem eller arkitektur.
Kvantisering i GGUF: Hvad betyder det, og hvordan påvirker det modellen?
Siden LLM-modellernes fremkomst er kvantiseringskonceptet blevet centralt: det involverer at reducere præcisionen (i bit) af AI-modellens interne "vægte" eller parametre under lagring eller eksport, f.eks. ændring fra 16-bit (FP16) eller endda 32-bit formater til meget lettere repræsentationer på 8, 5, 4 eller endda 2 bit. Det betyder, at modellen optager meget mindre plads, kræver mindre RAM og beregner meget hurtigere , til gengæld for et lille tab af præcision i svarene.
GGUF-formatet tager denne ekstreme fleksibilitet til sit højeste udtryk: det inkluderer flerniveau-"kvantiseringer" og er kompatibelt med både traditionelle tilgange (for at opnå maksimal kvalitet) og ultrakomprimerede niveauer justeret til begrænset hardware.
Vigtigste kvantiseringsskemaer i GGUF
Q4_K_M (eller Q4-varianter…): Den ideelle balance for de fleste brugere: den fylder kun lidt, er hurtig, og kvaliteten er næsten identisk med den originale model i hverdagens opgaver (spørgsmål og svar, programmering, skrivning, resuméer osv.). Dette er normalt den anbefalede standardværdi.
Q5_K_M: Anbefales, når du leder efter bedre kvalitet, og din hardware har tilstrækkelig VRAM (grafikhukommelse). Du vil opleve bedre resultater i komplekse ræsonnementsopgaver, avanceret matematik og krævende miljøer.
Q8_0: Den kompatible repræsentation af højeste kvalitet (næsten identisk med de ukomprimerede originaler). Anbefales kun, hvis du kan håndtere den store filstørrelse og har rigeligt med RAM/VRAM.
IQ4_XS: Det mindste og letteste format, der stadig kan bruges. Perfekt til test, hurtig eksperimentering eller enheder med meget lidt VRAM.
Undgå Q3 og Q2, hvis du leder efter kvalitet: Tabet af præcision er normalt meget mærkbart, og de er kun nyttige i meget begrænsede miljøer eller til specifikke opgaver.
Kvantificeringsniveauer: sammenligning og anvendelsesscenarier
Hvilket niveau skal man vælge? Det er her, GGUF-formatet udmærker sig med sin alsidighed. Afhængigt af dine behov kan du vælge:
2-bit kvantisering: Minimumsstørrelse, maksimal kompressionBruges i meget begrænsede enheder, men kvalitetstabet kan være stort.
4-bit kvantisering: Meget overlegen komprimering og hastighed med stort set intet kvalitetstab til almindelige opgaver. Foretrukken løsning for mange udviklere.
8-bit kvantisering: Næsten maksimal kvalitet og næsten ingen komprimering sammenlignet med de ubehandlede originaler.
Ved at kombinere dette med forskellige metoder (GPTQ, AWQ, QLoRA osv.) tillader GGUF, at den samme model implementeres med forskellige "varianter", der tilpasser sig hvert enkelt use case og tilgængelig hardware.
Hvilke praktiske fordele tilbyder GGUF brugere og virksomheder?
Ultrahurtig opladning: Takket være det binære format og den effektive struktur er det muligt at indlæse modeller på få sekunder, hvilket er vigtigt for tidsfølsomme eller hyppigt opdaterede applikationer og tjenester.
Portabilitet og standardisering: Deling, kopiering og installation af GGUF-modeller er lige så nemt som at flytte en enkelt fil, uden problemer med afhængigheder eller versionsstyring.
kompatibilitet: Det integrerer med et stort udvalg af frameworks (Python, R, CUDA osv.) og applikationer (fra Ollama til AnythingLLM, LM Studio eller brugerdefinerede chatbots).
Reduceret energiforbrug: GGUFs kvantiserede modeller kræver færre ressourcer og hjælper med at reducere elregningen og hardwarens CO2-aftryk, hvilket også letter deres brug i edge-enheder eller mobile løsninger.
Opgradering og skalerbarhed: Det er trivielt at inkorporere nye typer data eller parametre, så GGUF er forberedt på fremtidige fremskridt inden for AI-sektoren.
Hvor kan jeg downloade GGUF-filer, og hvordan integrerer jeg dem i mine projekter?
Den primære og mest populære kilde til GGUF-modeller er afsnittet GGUF Files på Hugging Face . Der kan du filtrere, søge og downloade tusindvis af gratis LLM-modeller og kvantiserede RAG-varianter på forskellige niveauer, klar til lokal brug.
Ud over Hugging Face giver nogle applikationer dig mulighed for at downloade modeller fra deres egne grænseflader eller endda overføre og administrere dem fra lokale mapper, eksportere eller importere dem til andre apps (såsom LM Studio, AnythingLLM eller Chatbox).
Sådan importerer du en downloadet GGUF-fil til Ollama
Download GGUF-modellen: Vælg det kvantiseringsniveau, der passer bedst til din hardware, og gem det i en lokal mappe.
Opret en modelfil: I samme mappe skal du oprette en fil (f.eks. "Modelfile") med en FROM-linje, der peger på det faktiske navn på din .gguf-fil. Dette fortæller Ollama, hvor modellen skal indlæses fra.
Indlæs modellen i Ollama: Kør den relevante kommando for at importere modellen ved hjælp af indstillingen “-f Modelfile”. Eksempel: ollama create myModelName -f Modelfile
Kør modellen: Du kan nu bruge den lokale model, som om du havde downloadet den fra standardbiblioteket.
Denne proces er meget ens for LM Studio, AnythingLLM og andre GGUF-kompatible applikationer.
Hvis der på den anden side allerede findes officielle versioner af modellen i din platforms bibliotek, er det endnu enklere at bruge den tilsvarende "pull"-kommando, men manuel import er nøglen, hvis du har brug for en specifik kvantiseringsvariant, en usædvanlig model, eller hvis du foretrækker større kontrol over, hvor og hvordan modellen gemmes.
Kompatible applikationer og primære anvendelser af GGUF-filer i den virkelige verden
GGUF-økosystemet er i øjeblikket meget omfattende. Se på de vigtigste projekter og anvendelsesscenarier:
OllamaGiver dig mulighed for at importere eksterne modeller, oprette dine egne og eksperimentere med kvantiseringsindstillinger og brugerdefinerede skabeloner.
LM StudioDen inkluderer en meget simpel grafisk brugerflade til at søge, downloade og installere GGUF-modeller, samt eksportere dem til andre apps eller konsultere dem via en lokal API.
Alt, LLM y JanDesktop- og virksomhedsløsninger til brug af lokale AI-chatbots, med fuld understøttelse af GGUF-modeller og forudtrænede skabeloner.
3DIMLITekniske ordlister og butikker, der tilbyder specifikke modeller eller materialer i GGUF, med anbefalinger til, hvordan man korrekt dokumenterer versioner og kompatibiliteter for hvert enkelt tilfælde.
Open source-projekter og forskningsmiljøer takket være interoperabilitet med Python og R.
Derudover er flere professionelle og kommercielle platforme begyndt at tilbyde færdige skabeloner i GGUF for at fremskynde implementeringen og integrationen af avancerede AI-løsninger.
Omhu og praktiske tips ved arbejde med GGUF-filer
Tjek altid kompatibilitet: Før du downloader en GGUF-fil, skal du kontrollere, at den er kompatibel med dit program (specifik version af Ollama, LM Studio osv.) og din hardware. Hvis modellen kræver en specifik motorversion, skal du kontrollere denne meddelelse på kildewebstedet..
Navngiv og organiser filerne omhyggeligt: Da nogle processer skelner mellem store og små bogstaver, skal du bruge enkle og klare navne for at undgå indlæsningsfejl.
Tilpas kvantificeringen til dit team: Selvom du kan importere Q8- eller Q5-modeller, er det bedre at vælge Q4 eller IQ4, hvis din VRAM er begrænset, for at undgå ressourcelåsning.
Tilpas skabeloner, hvis du opretter chatbots: Når du importerer chatmodeller, kan det være nødvendigt at justere promptskabelonen i modelfilen eller indstillingerne for at opnå mere stabile og naturlige svar.
Opmærksomhed på licenser og rettigheder: Nogle GGUF-modeller tilføjer brugsbegrænsninger. Tjek downloadsiden for at se, om du må bruge dem til kommercielle formål eller til videredistribution..
Anbefalinger til valg af den rigtige model og kvantificering
Som eksperter og brugere har bekræftet, er der en klar praktisk vejledning at følge:
Til hverdagsopgaver (chat, programmering, skrivning, generelle forespørgsler): vælg Q4_K_M. Det er det sande "sweet spot" i kvalitet/ydeevne og understøttes af næsten alle frameworks.
Til avanceret arbejde eller kompleks matematik: Hvis du har nok hukommelse, så opgrader til Q5_K_M, men normalt vil forskellen i kvalitet kun være mærkbar ved krævende opgaver.
Hardware i topklasse? Hvis du har investeret i en stor GPU og er interesseret i maksimal grafikkvalitet, kan du prøve Q8_0, men springet fra Q5 er ikke altid berettiget, undtagen i benchmarking eller forskning.
Begrænsede ressourcer? Prøv IQ4_XS til test, hurtige prototyper, eller når du virkelig mangler RAM/VRAM.
Undgå Q3/Q2 i virkelige eller professionelle miljøer, da det "lider" i sammenhæng og nøjagtighed af resultaterne.
Hvordan GGUF bidrager til udviklingen og fremtiden for lokal og open source AI
GGUF-formatet fremskynder ikke kun implementeringen af AI på personlige enheder, men demokratiserer også adgangen til avancerede modeller . Det gør det muligt for flere mennesker og virksomheder at:
Oplev de seneste fremskridt inden for generativ AI på første hånd uden at være afhængig af store virksomheder
Tilpas modeller, tilføj funktioner, og del skræddersyede versioner med fællesskaber eller forskningsgrupper.
Eksperimentér med forskellige arkitekturer, parametre og skalerbarhed uden frygt for uforenelighed eller blokeringer
GGUF fremmer også udviklingen af nye værktøjer, oversættere og motorer og sikrer, at den nuværende udvikling vil forblive nyttig i mange år fremover takket være dens udvidelige tilgang. Dens interoperabilitet og nemme dokumentation, bundling og eksport gør det til et standardformat i arkiver, butikker, tekniske ordlister og åbne fællesskabsprojekter.
Hvilke udfordringer og muligheder ligger forude for GGUF?
Selvom GGUF-formatet allerede er en benchmark, fortsætter fællesskabet med at debattere og tilføje forbedringer såsom:
Optimering til nye hardwarearkitekturer (mobile SoC'er, edge-enheder, FPGA'er osv.)
Udvikling af bedre konvertere mellem frameworks, for eksempel fra PyTorch eller TensorFlow direkte til GGUF
Større automatisering i justering af skabeloner og prompts til specifikke chatmodeller eller opgaver
Avanceret integration med kvantificeringsværktøjer, forbedringer i dokumentationssystemer og modelopdagelse
Alt dette vil betyde, at det vil blive stadig nemmere, hurtigere og mere overkommeligt at downloade, tilpasse og integrere avancerede AI-modeller , uanset om det er for SMV'er, forskere, entusiaster eller store platforme.
GGUF-formatet har etableret sig som den bedste løsning til at køre lokal, kontrolleret kunstig intelligens, der udnytter computerens ressourcer fremragende, uanset om det er en topmoderne maskine eller en mere beskeden en, og som nemt integrerer de nyeste LLM-modeller på markedet. Med det store udvalg af ressourcer, tutorials og kompatible applikationer, der er tilgængelige, tager det kun få minutter at finde, importere og begynde at bruge færdige modeller, hvilket optimerer både tid og omkostninger, samtidig med at man nyder maksimal privatliv og skalerbarhed. GGUF er nøglen til åbenhed, demokratisering og fremtiden for praktisk kunstig intelligens.