GGUF-Format: Was es ist, wie es funktioniert und wie man es für KI-Modelle nutzen kann
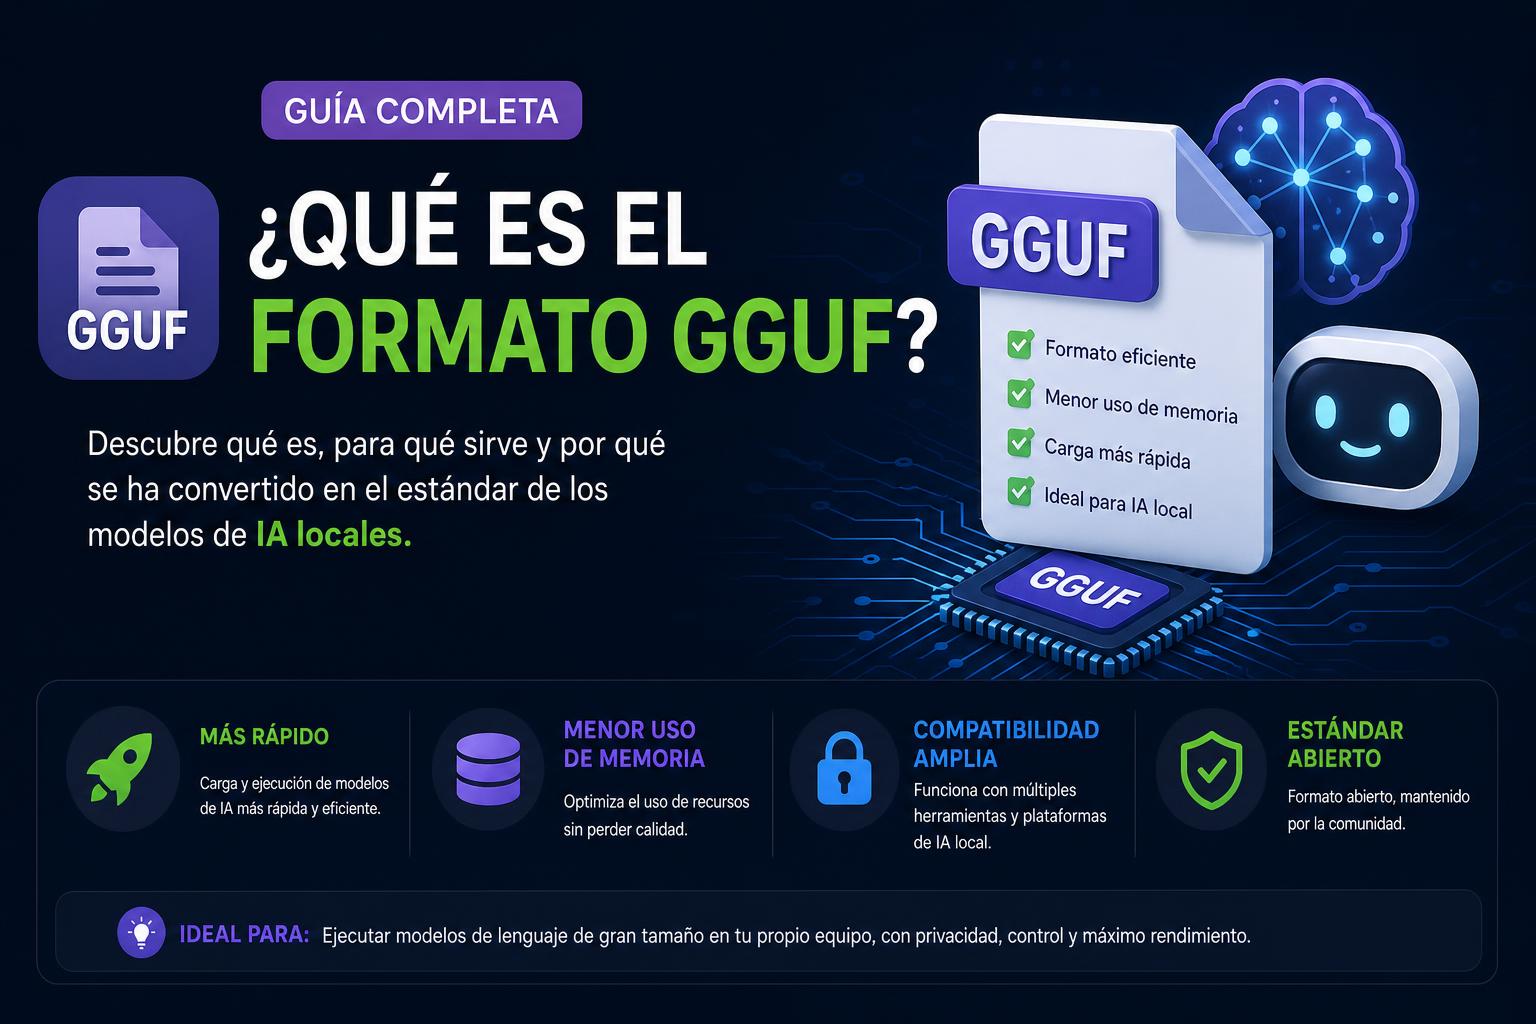
GGUF ist das Referenzformat für die gemeinsame Nutzung und Ausführung lokaler KI-Modelle und übertrifft frühere Formate in Flexibilität und Kompatibilität.
Durch die verschiedenen Quantisierungsstufen können Leistung und Ressourcenverbrauch an die Hardware jedes Benutzers angepasst werden, von einfachen Geräten bis hin zu leistungsstarken Workstations.
Das Herunterladen und Importieren von GGUF-Modellen in Anwendungen wie Ollama, LM Studio oder AnythingLLM ist einfach und ermöglicht es Ihnen, auch ohne Internetverbindung individuelle KI-Lösungen zu entwickeln.
Die große Community rund um GGUF, mit Repositories wie Gesicht umarmenDadurch wird es einfach, aktualisierte Versionen, Ressourcen und Unterstützung für verschiedene Anwendungsfälle zu finden.
Haben Sie in letzter Zeit von GGUF-Dateien gehört und sich gefragt, was sie sind und wofür sie verwendet werden ? Die Welt der künstlichen Intelligenz entwickelt sich rasant, und Dateiformate spielen eine entscheidende Rolle beim Ausführen leistungsstarker Modelle – sowohl für Profis als auch für Hobbyanwender, die das Maximum aus ihrer Hardware herausholen wollen.
In diesem ausführlichen Artikel werden wir alles rund um das GGUF-Format eingehend untersuchen: was es ist, wofür es entwickelt wurde, wie es die Verwendung großer Sprachmodelle (LLM) revolutioniert hat, seine Vorteile gegenüber früheren Formaten, die Quantisierungsstufen, wo man Modelle herunterladen kann und wie man sie in verschiedene KI-Plattformen und -Anwendungen integriert.
Das GGUF- Format (GGML Universal Format) ist eine Binärdatei, die speziell für das schnelle und effiziente Speichern und Laden großer KI-Modelle entwickelt wurde, insbesondere von LLM- Modellen (Sprachmodelle wie GPT, Llama, Gemma, Grok u. a.) und RAG-Modellen (Retrieval Augmented Generation) . GGUF basiert auf den Erfahrungen mit GGML und wurde an die aktuellen Bedürfnisse von Entwicklern, Unternehmen und der Community angepasst: Kompatibilität, Effizienz, Flexibilität und einfache Integration in verschiedene Plattformen und Anwendungen.
GGUF wurde als natürlicher Nachfolger des GGML-Formats entwickelt und bringt bemerkenswerte Verbesserungen mit sich, die der wachsenden Nachfrage nach weniger spezialisierter Hardware gerecht werden und sicherstellen, dass große KI-Modelle nicht nur auf leistungsstarken Servern oder in der Cloud, sondern auch auf Desktop-Computern, Laptops und sogar einigen Mobilgeräten mit begrenzten Ressourcen eingesetzt werden können.
Unterschiede und Vorteile im Vergleich zu GGML und anderen Formaten
Während GGML bereits eine deutliche Verbesserung gegenüber herkömmlichen Modellen darstellte, setzt GGUF in mehreren Schlüsselaspekten neue Maßstäbe . Betrachten wir die wichtigsten Unterschiede und Verbesserungen:
Erweiterbarkeit und eine sichere Zukunft: GGUF ist so konzipiert, dass neue Funktionalitäten, Metadatenoptionen oder Parameter, die zukünftige Modelle möglicherweise benötigen, integriert werden können, ohne die Abwärtskompatibilität zu verlieren. Dadurch können sowohl neue Entwicklungen als auch bestehende Werkzeuge leichter von Verbesserungen profitieren. ohne alles von Grund auf neu machen zu müssen.
Flexibilität im Aufbau: Es ermöglicht Ihnen, Modelldaten effizienter zu organisieren und sich an verschiedene Architekturen und Frameworks anzupassen, insbesondere für neuartige oder experimentelle KI-Modelle.
Interoperabilität und Kompatibilität: GGUF wurde so konzipiert, dass es nahtlos in einer Vielzahl von Umgebungen eingesetzt werden kann: von Python- oder R-Anwendungen bis hin zu Engines wie llama.cpp, Ollama, AnythingLLM oder LM Studio. Dies ermöglicht es Benutzern, Modelle zu teilen, herunterzuladen und zu importieren, ohne sich Gedanken über Inkompatibilitäten oder Änderungen in Arbeitsabläufen machen zu müssen..
Optimierte Größe und schnelles Laden: Dank verschiedener Komprimierungs- und Quantisierungsstufen sind GGUF-Dateien deutlich kleiner und lassen sich schneller laden. Speicherplatz sparen und Inferenz beschleunigen (Echtzeit-Modellreaktion).
Aktive Unterstützung und Gemeinschaft: Da es sich um einen offenen und sich ständig weiterentwickelnden Standard handelt, gibt es eine große Community, die sich sowohl an der Entwicklung des Formats als auch an der Erstellung und dem Testen neuer, optimierter und dokumentierter Versionen von Modellen beteiligt.
Wozu dient GGUF und was ermöglicht es Ihnen?
Das GGUF-Format dient primär der Speicherung von KI-Modellen in einem kompakten, portablen und hocheffizienten Format, das speziell für die lokale Ausführung entwickelt wurde. So können Sie vortrainierte, hochmoderne Modelle (wie GPT, Gemma, Llama, Grok, Mistral usw.) herunterladen und auf Ihrem eigenen Computer ausführen – ohne auf Cloud-Dienste angewiesen zu sein, ohne personenbezogene Daten an andere Unternehmen zu übermitteln und mit auf Ihre Bedürfnisse zugeschnittenen Echtzeit-Antworten.
Diese Funktion ist besonders nützlich für:
Entwickler von KI-Chatbot-Anwendungen, persönlichen Assistenten, intelligenten Suchmaschinen oder fortgeschrittenen Textverarbeitungs- und Analyseaufgaben.
Fachleute, die Datenschutzerklärung absolut in seinen KI-Prozessen, angesichts der lokalen Natur der GGUF-Modelle.
Menschen, die Kosten und Ressourcen optimieren und wiederkehrende Zahlungen für externe APIs oder Online-Dienste vermeiden möchten.
Unternehmen und Einzelpersonen, die daran interessiert sind, mit KI-Modellen offline zu experimentieren, sie zu optimieren oder mit ihnen zu arbeiten.
Bildungs- und Forschungsumgebungen, in denen der Austausch von Modellen und Anpassungen zwischen Nutzern verschiedener Plattformen Priorität hat.
Woher stammt GGUF und wie unterscheidet es sich von Formaten wie PyTorch, Safetensors, GPTQ usw.?
Die Familie der Formate für KI-Modelle ist sehr vielfältig , aber jedes Format reagiert auf unterschiedliche Bedürfnisse und Einschränkungen:
PyTorch (.pth, .pt, Binärdateien, SafeTensoren…): Sie werden häufig während des Trainings oder der Feinabstimmung in Entwicklungsumgebungen eingesetzt und erfordern in der Regel leistungsstarke Hardware, die ausschließlich über eine GPU verfügt. Darüber hinaus enthalten sie eine große Menge an Metadaten und Code, was ihren Umfang und ihre Komplexität erhöht..
GGML: Es wurde als Reaktion auf die Notwendigkeit lokaler Inferenz entwickelt, wurde aber dank der zuvor erwähnten Verbesserungen schnell von GGUF überholt.
GGUF: Es wurde entwickelt, um Portabilität, Kompatibilität und die Möglichkeit einfacher Aktualisierungen sowie moderne Quantisierungsverfahren abzudecken.
GPTQ, AWQ, EXL2, QLoRA, LoRA…: Konklusion Quantisierungs- und Feinabstimmungsmethoden Diese Methoden ermöglichen eine drastische Reduzierung der Modellgröße bei gleichzeitiger Anpassung der Genauigkeit und optimaler Nutzung von Ressourcen wie GPUs oder CPUs. Viele GGUF-Modelle werden mithilfe dieser Methoden quantisiert.
Zusammenfassend lässt sich sagen, dass das GGUF-Format nicht nur für die lokale Inferenz konzipiert ist, sondern auch für die gemeinsame Nutzung von Modellen, die unabhängig vom Betriebssystem oder der Architektur auf einer Vielzahl von Tools und Plattformen eingesetzt werden können.
Quantisierung in GGUF: Was bedeutet das und wie wirkt sie sich auf das Modell aus?
Seit dem Aufkommen von LLM-Modellen ist das Konzept der Quantisierung von zentraler Bedeutung: Dabei wird die Genauigkeit (in Bit) der internen „Gewichte“ oder Parameter des KI-Modells beim Speichern oder Exportieren reduziert, beispielsweise durch den Wechsel von 16-Bit- (FP16) oder sogar 32-Bit-Formaten zu deutlich kleineren Darstellungen mit 8, 5, 4 oder sogar 2 Bit. Dadurch benötigt das Modell wesentlich weniger Speicherplatz, weniger Arbeitsspeicher und rechnet deutlich schneller , allerdings auf Kosten eines geringfügigen Genauigkeitsverlusts bei den Ergebnissen.
Das GGUF-Format treibt diese extreme Flexibilität auf die Spitze: Es beinhaltet mehrstufige „Quantisierungen“ und ist sowohl mit traditionellen Ansätzen (um maximale Qualität zu erzielen) als auch mit ultra-komprimierten Stufen kompatibel, die an begrenzte Hardware angepasst sind.
Hauptquantisierungsschemata in GGUF
Q4_K_M (oder Q4-Varianten…): Die ideale Balance für die meisten Benutzer: Es benötigt wenig Platz, ist schnell und die Qualität ist bei alltäglichen Aufgaben (Fragen und Antworten, Programmierung, Schreiben, Zusammenfassungen usw.) nahezu identisch mit dem Originalmodell. Dies ist üblicherweise der empfohlene Standardwert..
Q5_K_M: Empfehlenswert, wenn Sie eine höhere Qualität wünschen und Ihre Hardware über ausreichend VRAM (Grafikspeicher) verfügt. Sie werden bessere Ergebnisse bei komplexen Denkaufgaben, fortgeschrittener Mathematik und anspruchsvollen Umgebungen feststellen.
Q8_0: Die qualitativ hochwertigste kompatible Darstellung (nahezu identisch mit den unkomprimierten Originalen). Nur empfehlenswert, wenn Sie mit der großen Dateigröße umgehen können und über ausreichend RAM/VRAM verfügen..
IQ4_XS: Das kleinste und leichteste Format, das noch verwendbar ist. Ideal für Tests, schnelle Experimente oder Geräte mit sehr wenig VRAM.
Meiden Sie Q3 und Q2, wenn Sie Wert auf Qualität legen: Der Präzisionsverlust ist meist sehr deutlich spürbar, und sie sind nur in sehr eingeschränkten Umgebungen oder für spezifische Aufgaben sinnvoll.
Quantifizierungsebenen: Vergleich und Anwendungsfälle
Welches Level ist das richtige? Hier zeigt das GGUF-Format seine Vielseitigkeit. Je nach Bedarf können Sie wählen:
2-Bit-Quantisierung: Mindestgröße maximale KompressionWird nur in sehr wenigen Geräten verwendet, der Qualitätsverlust kann jedoch hoch sein.
4-Bit-Quantisierung: Höchste Komprimierungs- und Geschwindigkeitsleistung bei praktisch keinem Qualitätsverlust für gängige Aufgaben. Bevorzugte Lösung für viele Entwickler.
8-Bit-Quantisierung: Nahezu maximale Wiedergabetreue und kaum Komprimierung im Vergleich zu den unbearbeiteten Originalen.
Durch die Kombination mit verschiedenen Methoden (GPTQ, AWQ, QLoRA usw.) ermöglicht GGUF die Bereitstellung desselben Modells in verschiedenen Varianten, angepasst an den jeweiligen Anwendungsfall und die verfügbare Hardware.
Welche praktischen Vorteile bietet GGUF Nutzern und Unternehmen?
Ultraschnelles Laden: Dank des Binärformats und der effizienten Struktur können Modelle in Sekundenschnelle geladen werden, was für zeitkritische oder häufig aktualisierte Anwendungen und Dienste wichtig ist.
Portabilität und Standardisierung: Das Teilen, Kopieren und Installieren von GGUF-Modellen ist so einfach wie das Verschieben einer einzelnen Datei, ohne jegliche Probleme mit Abhängigkeiten oder Versionsverwaltung.
Kompatibilität: Es lässt sich mit einer Vielzahl von Frameworks (Python, R, CUDA usw.) und Anwendungen integrieren (von Ollama über AnythingLLM und LM Studio bis hin zu benutzerdefinierten Chatbots).
Reduzierter Energieverbrauch: Die quantisierten Modelle von GGUF benötigen weniger Ressourcen und tragen so zur Senkung der Stromkosten und des CO2-Fußabdrucks der Hardware bei. Dadurch wird auch deren Einsatz in Edge-Geräten oder mobilen Lösungen erleichtert.
Upgradefähigkeit und Skalierbarkeit: Die Einbindung neuer Datentypen oder Parameter ist trivial, daher ist GGUF für zukünftige Fortschritte im Bereich der KI bestens gerüstet.
Wo kann ich GGUF-Dateien herunterladen und wie integriere ich sie in meine Projekte?
Die wichtigste und beliebteste Quelle für GGUF-Modelle ist der Bereich „GGUF Files“ auf Hugging Face . Dort können Sie Tausende von kostenlosen LLM-Modellen und quantisierten RAG-Varianten in verschiedenen Auflösungen filtern, suchen und herunterladen, die Sie direkt lokal verwenden können.
Neben Hugging Face bieten einige Anwendungen die Möglichkeit, Modelle über ihre eigenen Benutzeroberflächen herunterzuladen oder sie sogar aus lokalen Verzeichnissen zu übertragen und zu verwalten sowie in andere Anwendungen (wie LM Studio, AnythingLLM oder Chatbox) zu exportieren oder zu importieren.
Wie importiert man eine heruntergeladene GGUF-Datei in Ollama?
Laden Sie das GGUF-Modell herunter: Wählen Sie die Quantisierungsstufe, die am besten zu Ihrer Hardware passt, und speichern Sie sie in einem lokalen Ordner.
Erstellen Sie eine Modelldatei: Erstellen Sie im selben Verzeichnis eine Datei (z. B. „Modelfile“) mit einer FROM-Zeile, die auf den tatsächlichen Namen Ihrer .gguf-Datei verweist. Dadurch wird Ollama mitgeteilt, wo das Modell geladen werden soll.
Laden Sie das Modell in Ollama: Führen Sie den entsprechenden Befehl aus, um das Modell mit der Option „-f Modelldatei“ zu importieren. Beispiel: ollama create myModelName -f Modelfile
Modell ausführen: Sie können das lokale Modell nun so verwenden, als hätten Sie es aus der Standardbibliothek heruntergeladen.
Dieser Prozess ist für LM Studio, AnythingLLM und andere GGUF-kompatible Anwendungen sehr ähnlich.
Sind hingegen bereits offizielle Versionen des Modells in der Bibliothek Ihrer Plattform vorhanden, ist die Verwendung des entsprechenden "pull"-Befehls noch einfacher. Der manuelle Import ist jedoch unerlässlich, wenn Sie eine bestimmte Quantisierungsvariante oder ein ungewöhnliches Modell benötigen oder wenn Sie mehr Kontrolle darüber haben möchten, wo und wie das Modell gespeichert wird.
Kompatible Anwendungen und wichtigste praktische Einsatzgebiete von GGUF-Dateien
Das GGUF-Ökosystem ist aktuell sehr umfangreich. Werfen Sie einen Blick auf die wichtigsten Projekte und Anwendungsfälle:
Ollama: Ermöglicht den Import externer Modelle, die Erstellung eigener Modelle und das Experimentieren mit Quantisierungseinstellungen und benutzerdefinierten Vorlagen.
LM StudioEs beinhaltet eine sehr einfache grafische Benutzeroberfläche zum Suchen, Herunterladen und Installieren von GGUF-Modellen sowie zum Exportieren in andere Anwendungen oder zum Abfragen über eine lokale API.
Alles LLM y JanuarDesktop- und Unternehmenslösungen für den Einsatz lokaler KI-Chatbots mit voller Unterstützung für GGUF-Modelle und vortrainierte Vorlagen.
3DIMLITechnische Glossare und Shops, die bestimmte Modelle oder Materialien in GGUF anbieten, mit Empfehlungen zur korrekten Dokumentation von Versionen und Kompatibilitäten für jedes Gehäuse.
Open-Source-Projekte und Forschungsumgebungen dank Interoperabilität mit Python und R.
Darüber hinaus bieten immer mehr professionelle und kommerzielle Plattformen vorgefertigte Vorlagen in GGUF an, um die Bereitstellung und Integration fortschrittlicher KI-Lösungen zu beschleunigen.
Sorgfaltshinweise und praktische Tipps für die Arbeit mit GGUF-Dateien
Prüfen Sie stets die Kompatibilität: Bevor Sie eine GGUF-Datei herunterladen, prüfen Sie, ob sie mit Ihrer Anwendung (spezielle Version von Ollama, LM Studio usw.) und Ihrer Hardware kompatibel ist. Falls für das Modell eine bestimmte Motorversion erforderlich ist, überprüfen Sie den entsprechenden Hinweis auf der Quellwebsite..
Benennen und organisieren Sie die Dateien sorgfältig: Da bei einigen Prozessen zwischen Groß- und Kleinschreibung unterschieden wird, verwenden Sie einfache und eindeutige Namen, um Ladefehler zu vermeiden.
Passen Sie die Quantifizierung an Ihr Team an: Obwohl Sie Q8- oder Q5-Modelle importieren können, ist es bei begrenztem VRAM besser, sich für Q4 oder IQ4 zu entscheiden, um Ressourcenengpässe zu vermeiden.
Passen Sie die Vorlagen an, wenn Sie Chatbots erstellen: Beim Importieren von Chat-Modellen kann es erforderlich sein, die Prompt-Vorlage in der Modelldatei oder in den Einstellungen anzupassen, um stabilere und natürlichere Antworten zu erzielen.
Achtung bei Lizenzen und Rechten: Bei einigen GGUF-Modellen gelten zusätzliche Nutzungsbeschränkungen. Prüfen Sie auf der Downloadseite, ob Sie die Dateien für kommerzielle Zwecke oder zur Weiterverbreitung verwenden dürfen..
Empfehlungen zur Auswahl des richtigen Modells und zur Quantifizierung
Wie Experten und Anwender bestätigt haben, gibt es eine klare, praktische Anleitung:
Für alltägliche Aufgaben (Chatten, Programmieren, Schreiben, allgemeine Anfragen): Wählen Sie Q4_K_M. Es ist der optimale Kompromiss zwischen Qualität und Leistung und wird von nahezu allen Frameworks unterstützt.
Für fortgeschrittene Aufgaben oder komplexe Mathematik: Wenn Sie über genügend Arbeitsspeicher verfügen, sollten Sie auf Q5_K_M upgraden, normalerweise ist der Qualitätsunterschied jedoch nur bei anspruchsvollen Aufgaben bemerkbar.
Hochwertige Hardware? Wenn Sie in eine große GPU investiert haben und an maximaler Wiedergabetreue interessiert sind, können Sie Q8_0 ausprobieren, aber der Sprung von Q5 ist außer bei Benchmarks oder Forschungszwecken nicht immer gerechtfertigt.
Begrenzte Ressourcen? Probieren Sie IQ4_XS für Tests, schnelle Prototypen oder wenn Sie wirklich wenig RAM/VRAM haben.
Vermeiden Sie Q3/Q2 für reale oder professionelle Umgebungenda es an Kohärenz und Genauigkeit der Ergebnisse „leidet“.
Wie GGUF zur Entwicklung und Zukunft lokaler und Open-Source-KI beiträgt
Das GGUF-Format beschleunigt nicht nur die Verbreitung von KI auf persönlichen Geräten, sondern demokratisiert auch den Zugang zu fortschrittlichen Modellen . Es ermöglicht mehr Menschen und Unternehmen:
Erleben Sie die neuesten Fortschritte im Bereich der generativen KI aus erster Hand, ohne auf große Konzerne angewiesen zu sein.
Passen Sie Modelle an, fügen Sie Funktionen hinzu und teilen Sie maßgeschneiderte Versionen mit Communities oder Forschungsgruppen.
Experimentieren Sie mit verschiedenen Architekturen, Parametern und Skalierbarkeit. ohne Angst vor Unverträglichkeiten oder Blockaden
GGUF fördert zudem die Entwicklung neuer Werkzeuge, Übersetzer und Engines und stellt dank seines erweiterbaren Ansatzes sicher, dass aktuelle Entwicklungen auch in Zukunft nützlich bleiben. Seine Interoperabilität sowie die einfache Dokumentation, Bündelung und der Export machen es zu einem Standardformat in Repositories, Datenspeichern, technischen Glossaren und offenen Community-Projekten.
Welche Herausforderungen und Chancen erwarten GGUF in der Zukunft?
Obwohl das GGUF-Format bereits als Maßstab gilt, diskutiert die Community weiterhin darüber und fügt Verbesserungen hinzu, wie zum Beispiel:
Optimierung für neue Hardwarearchitekturen (mobile SoCs, Edge-Geräte, FPGAs usw.)
Entwicklung besserer Konverter zwischen Frameworks, beispielsweise von PyTorch oder TensorFlow direkt zu GGUF
Stärkere Automatisierung bei der Anpassung von Vorlagen und Eingabeaufforderungen für spezifische Chatmodelle oder Aufgaben
Erweiterte Integration mit Quantifizierungswerkzeugen, Verbesserungen in Dokumentationssystemen und Modellfindung
All dies wird dazu führen, dass das Herunterladen, Anpassen und Integrieren fortschrittlicher KI-Modelle für KMU, Forscher, Enthusiasten und große Plattformen gleichermaßen immer einfacher, schneller und kostengünstiger wird .
Das GGUF-Format hat sich als optimale Lösung für die lokale, kontrollierte Ausführung künstlicher Intelligenz etabliert. Es nutzt die Ressourcen Ihres Computers – egal ob High-End- oder Standardrechner – optimal und integriert problemlos die neuesten LLM-Modelle. Dank der Fülle an verfügbaren Ressourcen, Tutorials und kompatiblen Anwendungen lassen sich fertige Modelle in wenigen Minuten finden, importieren und einsetzen. So optimieren Sie Zeit und Kosten bei gleichzeitig maximaler Privatsphäre und Skalierbarkeit. GGUF ist der Schlüssel zu Offenheit, Demokratisierung und Zukunft praktischer künstlicher Intelligenz.