Formato GGUF: cos'è, come funziona e come sfruttarlo per i modelli di intelligenza artificiale.
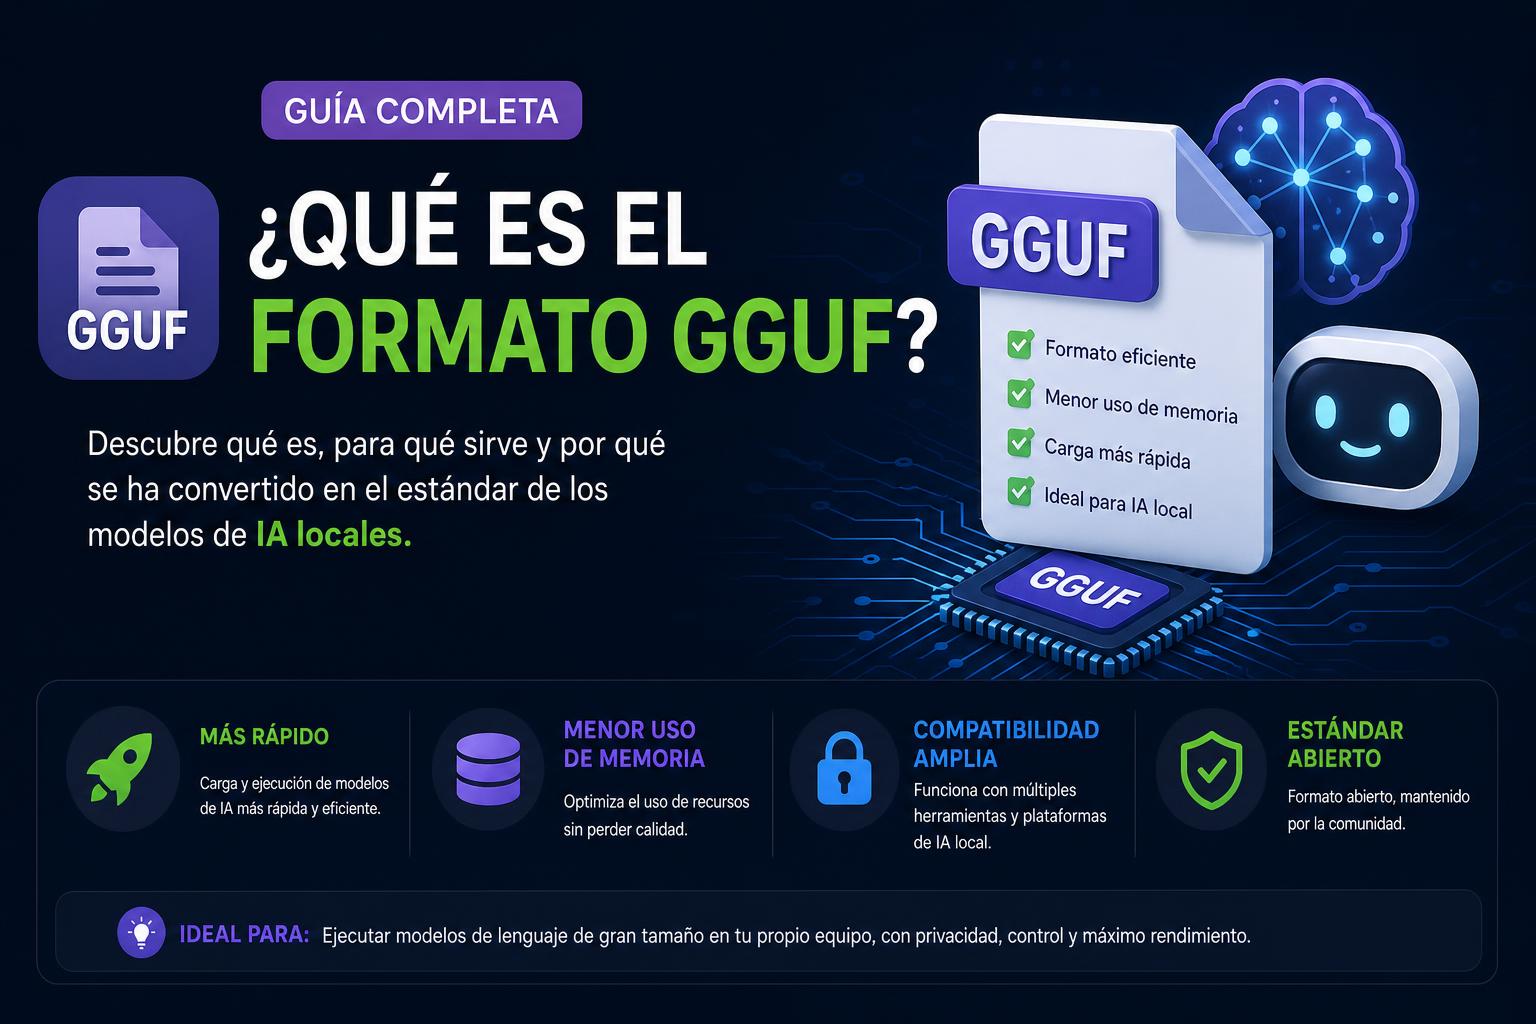
GGUF è il formato di riferimento per la condivisione e l'esecuzione di modelli di intelligenza artificiale locali, superando i formati precedenti in termini di flessibilità e compatibilità.
I suoi diversi livelli di quantizzazione consentono di adattare le prestazioni e il consumo di risorse all'hardware di ciascun utente, dalle apparecchiature più modeste alle workstation più potenti.
Scaricare e importare modelli GGUF in applicazioni come Ollama, LM Studio o AnythingLLM è semplice e consente di sviluppare soluzioni di intelligenza artificiale personalizzate anche senza connessione a Internet.
La grande comunità attorno a GGUF, con repository come Abbracciare il visoConsente di trovare facilmente versioni aggiornate, risorse e supporto per diversi casi d'uso.
Avete sentito parlare di recente dei file GGUF e vi siete chiesti cosa siano e a cosa servano ? Il mondo dell'intelligenza artificiale sta avanzando a passi da gigante e i formati di file svolgono un ruolo cruciale nell'esecuzione di modelli potenti, sia per i professionisti che per gli appassionati che desiderano ottenere il massimo dalle proprie risorse.
In questo articolo esaustivo, esploreremo a fondo tutto ciò che riguarda il formato GGUF: cos'è, a cosa serve, come ha rivoluzionato l'utilizzo dei modelli linguistici di grandi dimensioni (LLM), i suoi vantaggi rispetto ai formati precedenti, i livelli di quantizzazione, dove scaricare i modelli e come integrarli in diverse piattaforme e applicazioni di intelligenza artificiale.
Il formato GGUF (GGML Universal Format) è un file binario specificamente progettato per archiviare, salvare e caricare in modo rapido ed efficiente modelli di intelligenza artificiale di grandi dimensioni, principalmente modelli LLM (Language Models come GPT, Llama, Gemma, Grok, tra gli altri) e modelli RAG (Retrieval Augmented Generation) . Il GGUF è nato dall'esperienza precedente con il GGML, adattandosi alle esigenze attuali di sviluppatori, aziende e comunità: compatibilità, efficienza, flessibilità e facilità di integrazione su diverse piattaforme e applicazioni.
GGUF è stato sviluppato come naturale successore del formato GGML , apportando notevoli miglioramenti che rispondono alla crescente domanda di hardware meno specializzato, garantendo che i modelli di intelligenza artificiale di grandi dimensioni possano essere utilizzati non solo su server potenti o nel cloud, ma anche su computer desktop, laptop e persino su alcuni dispositivi mobili con risorse limitate.
Differenze e vantaggi rispetto a GGML e ad altri formati
Sebbene GGML rappresentasse già un significativo miglioramento rispetto ai modelli tradizionali, GGUF alza ulteriormente l'asticella in diversi aspetti chiave. Analizziamo le principali differenze e i miglioramenti:
Estensibilità e un futuro sicuro: GGUF è progettato per integrare nuove funzionalità, opzioni di metadati o parametri che i modelli futuri potrebbero richiedere, senza perdere la compatibilità con le versioni precedenti. Ciò facilita sia i nuovi sviluppi che gli strumenti esistenti a beneficiare dei miglioramenti senza dover rifare tutto da zero.
Flessibilità nella struttura: Consente di organizzare i dati del modello in modo più efficiente, adattandosi a diverse architetture e framework, soprattutto per i modelli di intelligenza artificiale emergenti o sperimentali.
Interoperabilità e compatibilità: GGUF è stato progettato per essere utilizzato senza problemi in un'ampia gamma di ambienti: dalle applicazioni Python o R a motori come llama.cpp, Ollama, AnythingLLM o LM Studio. Ciò consente agli utenti di condividere, scaricare e importare modelli senza preoccuparsi di incompatibilità o modifiche ai flussi di lavoro..
Dimensioni ottimizzate e caricamento rapido: Grazie a vari livelli di compressione e quantizzazione, i file GGUF rendono i modelli molto più leggeri e veloci da caricare. Risparmio di memoria e accelerazione dell'inferenza (risposta del modello in tempo reale).
Supporto attivo e comunità: Essendo uno standard aperto e in continua evoluzione, esiste una vasta comunità che partecipa sia allo sviluppo del formato sia alla creazione e al collaudo di nuove versioni ottimizzate e documentate dei modelli.
A cosa serve GGUF e cosa permette di fare?
Il formato GGUF viene utilizzato principalmente per archiviare modelli di intelligenza artificiale in un formato compatto, portatile ed estremamente efficiente, specificamente progettato per l'esecuzione locale. Ciò consente di scaricare modelli pre-addestrati all'avanguardia (come GPT, Gemma, Llama, Grok, Mistral, ecc.) ed eseguirli sul proprio computer, senza dipendere da servizi cloud, senza inviare dati personali ad altre aziende e con risposte in tempo reale personalizzate in base alle proprie esigenze.
Questa funzionalità è particolarmente utile per:
Sviluppatori di applicazioni chatbot basate sull'intelligenza artificiale, assistenti personali, motori di ricerca intelligenti o sistemi avanzati di elaborazione e analisi del testo.
Professionisti che necessitano privacy assoluto nei suoi processi di intelligenza artificiale, data la natura locale dei modelli GGUF.
Persone che desiderano ottimizzare costi e risorse, evitando pagamenti ricorrenti per API esterne o servizi online.
Aziende e privati interessati a sperimentare, perfezionare o lavorare con modelli di intelligenza artificiale offline.
Ambienti didattici e di ricerca in cui la condivisione di modelli e adattamenti tra utenti di piattaforme diverse è una priorità.
Da dove proviene GGUF e in cosa si differenzia da formati come PyTorch, Safetensors, GPTQ, ecc.?
La famiglia di formati per i modelli di intelligenza artificiale è molto variegata , ma ognuno risponde a esigenze e limitazioni diverse:
PyTorch (pth, .pt, binari, safetensors…): Sono comunemente utilizzati durante l'addestramento o la messa a punto in ambienti di sviluppo e solitamente richiedono hardware potente dotato esclusivamente di GPU. Inoltre, includono una grande quantità di metadati e codice, il che ne aumenta le dimensioni e la complessità..
GGML: È stato creato per facilitare l'inferenza locale, ma è stato rapidamente superato da GGUF grazie ai miglioramenti sopra menzionati.
GGUF: È stato creato per garantire portabilità, compatibilità e possibilità di facile aggiornamento, oltre a supportare moderni schemi di quantizzazione.
GPTQ, AWQ, EXL2, QLoRA, LoRA…: Conclusione metodi di quantizzazione e messa a punto Questi metodi consentono una drastica riduzione delle dimensioni del modello, mantenendo al contempo la precisione e sfruttando in modo ottimale risorse come GPU o CPU. Molti modelli GGUF vengono quantizzati utilizzando questi metodi.
In sintesi, il formato GGUF è progettato non solo per l'inferenza locale, ma anche per la condivisione di modelli pronti all'uso su un'ampia varietà di strumenti e piattaforme, indipendentemente dal sistema operativo o dall'architettura.
Quantizzazione in GGUF: cosa significa e come influenza il modello?
Dall'avvento dei modelli LLM, il concetto di quantizzazione è diventato fondamentale: consiste nel ridurre la precisione (in bit) dei "pesi" o parametri interni del modello di IA durante il salvataggio o l'esportazione, passando, ad esempio, da formati a 16 bit (FP16) o addirittura a 32 bit a rappresentazioni molto più leggere a 8, 5, 4 o persino 2 bit. Ciò significa che il modello occupa molto meno spazio, richiede meno RAM e calcola molto più velocemente , a fronte di una leggera perdita di precisione nelle risposte.
Il formato GGUF porta questa estrema flessibilità alla sua massima espressione: include "quantizzazioni" multilivello ed è compatibile sia con gli approcci tradizionali (per ottenere la massima qualità) sia con livelli di ultracompressione adattati ad hardware limitato.
Principali schemi di quantizzazione in GGUF
Q4_K_M (o varianti Q4…): L'equilibrio ideale per la maggior parte degli utenti: occupa poco spazio, è veloce e la qualità è pressoché identica al modello originale nelle attività quotidiane (domande e risposte, programmazione, scrittura, riassunti, ecc.). Questo è solitamente il valore predefinito consigliato.
Q5_K_M: Consigliata se cercate una qualità superiore e il vostro hardware dispone di sufficiente VRAM (memoria grafica). Noterete risultati migliori in attività di ragionamento complesse, calcoli matematici avanzati e ambienti esigenti.
Q8_0: Rappresentazione compatibile di altissima qualità (pressoché identica agli originali non compressi). Consigliato solo se si è in grado di gestire file di grandi dimensioni e si dispone di molta RAM/VRAM..
IQ4_XS: Il formato più piccolo e leggero che sia ancora utilizzabile. Ideale per test, esperimenti rapidi o dispositivi con pochissima VRAM..
Evitate i quartili 3 e 2 se cercate la qualità: La perdita di precisione è solitamente molto evidente e questi strumenti sono utili solo in ambienti molto ristretti o per compiti specifici.
Livelli di quantificazione: confronto e casi d'uso
Quale livello scegliere? È qui che il formato GGUF si distingue per la sua versatilità. A seconda delle tue esigenze, puoi scegliere:
Quantizzazione a 2 bit: Dimensioni minime, compressione massimaUtilizzato in un numero molto limitato di dispositivi, ma la perdita di qualità può essere elevata.
Quantizzazione a 4 bit: Compressione e velocità nettamente superiori, praticamente senza alcuna perdita di qualità per le attività più comuni. Soluzione preferita da molti sviluppatori.
Quantizzazione a 8 bit: Fedeltà pressoché massima e compressione minima rispetto agli originali non elaborati.
Combinando questo approccio con diversi metodi (GPTQ, AWQ, QLoRA, ecc.), GGUF consente di implementare lo stesso modello con diverse "varianti", adattandosi a ciascun caso d'uso e all'hardware disponibile.
Quali vantaggi pratici offre GGUF a utenti e aziende?
Ricarica ultraveloce: Grazie al suo formato binario e alla sua struttura efficiente, è possibile caricare i modelli in pochi secondi, aspetto importante per applicazioni e servizi sensibili al fattore tempo o che necessitano di aggiornamenti frequenti.
Portabilità e standardizzazione: Condividere, copiare e installare i modelli GGUF è facile come spostare un singolo file, senza problemi di dipendenze o versioni.
Compatibilità: Si integra con una vasta gamma di framework (Python, R, CUDA, ecc.) e applicazioni (da Ollama ad AnythingLLM, LM Studio o chatbot personalizzati).
Consumo energetico ridotto: I modelli quantizzati di GGUF, richiedendo meno risorse, contribuiscono a ridurre la bolletta elettrica e l'impronta di carbonio dell'hardware, facilitandone inoltre l'utilizzo in dispositivi edge o soluzioni mobili.
Aggiornamento e scalabilità: L'integrazione di nuovi tipi di dati o parametri è banale, quindi GGUF è pronta per i futuri progressi nel settore dell'IA.
Dove posso scaricare i file GGUF e come posso integrarli nei miei progetti?
La fonte principale e più popolare di modelli GGUF è la sezione GGUF Files su Hugging Face . Lì è possibile filtrare, cercare e scaricare migliaia di modelli LLM gratuiti e varianti RAG quantizzate a diversi livelli, pronti per l'uso locale.
Oltre a Hugging Face, alcune applicazioni consentono di scaricare modelli dalle proprie interfacce o persino di trasferirli e gestirli da directory locali, esportandoli o importandoli in altre app (come LM Studio, AnythingLLM o Chatbox).
Come importare un file GGUF scaricato in Ollam
Scarica il modello GGUF: Scegli il livello di quantizzazione più adatto al tuo hardware e salvalo in una cartella locale.
Crea un file modello: Nella stessa directory, crea un file (ad esempio, "Modelfile") con una riga FROM che punti al nome effettivo del tuo file .gguf. Questo indica a Ollama da dove caricare il modello.
Carica il modello in Ollam: Eseguire il comando appropriato per importare il modello utilizzando l'opzione "-f Modelfile". Esempio: ollama create myModelName -f Modelfile
Esegui il modello: Ora puoi utilizzare il modello locale come se lo avessi scaricato dalla libreria standard.
Questo processo è molto simile per LM Studio, AnythingLLM e altre applicazioni compatibili con GGUF.
D'altra parte, se le versioni ufficiali del modello sono già presenti nella libreria della tua piattaforma, è ancora più semplice utilizzare il comando "pull" corrispondente, ma l'importazione manuale è fondamentale se hai bisogno di una variante di quantizzazione specifica, di un modello insolito o se preferisci un maggiore controllo su dove e come il modello viene memorizzato.
Applicazioni compatibili e principali utilizzi pratici dei file GGUF
L' ecosistema GGUF è attualmente molto esteso. Dai un'occhiata ai principali progetti e casi d'uso:
OllamaConsente di importare modelli esterni, crearne di propri e sperimentare con le impostazioni di quantizzazione e i modelli personalizzati.
Studio LMInclude un'interfaccia grafica molto semplice per cercare, scaricare e installare modelli GGUF, nonché per esportarli in altre applicazioni o consultarli tramite API locale.
Qualunque cosaLLM y GenSoluzioni desktop e aziendali per l'utilizzo di chatbot AI locali, con supporto completo per modelli GGUF e modelli pre-addestrati.
3DIMLIGlossari tecnici e negozi che offrono modelli o materiali specifici in GGUF, con raccomandazioni su come documentare correttamente versioni e compatibilità per ogni caso.
Progetti open source e ambienti di ricerca, grazie all'interoperabilità con Python e R.
Inoltre, diverse piattaforme professionali e commerciali stanno iniziando a offrire modelli predefiniti in GGUF per accelerare l'implementazione e l'integrazione di soluzioni di intelligenza artificiale avanzate.
Consigli pratici e indicazioni per lavorare con i file GGUF
Verificare sempre la compatibilità: Prima di scaricare un file GGUF, verifica che sia compatibile con la tua applicazione (versione specifica di Ollama, LM Studio, ecc.) e con il tuo hardware. Se il modello richiede una versione specifica del motore, verifica questa informazione sul sito web del produttore..
Denominare e organizzare i file con cura: Poiché alcuni processi distinguono tra maiuscole e minuscole, utilizza nomi semplici e chiari per evitare errori di caricamento.
Adatta la quantificazione al tuo team: Sebbene sia possibile importare modelli Q8 o Q5, se la VRAM disponibile è limitata è preferibile optare per Q4 o IQ4, evitando così blocchi delle risorse.
Personalizza i modelli se crei dei chatbot: Quando si importano modelli di chat, potrebbe essere necessario modificare il modello di prompt nel file del modello o nelle impostazioni per ottenere risposte più stabili e naturali.
Attenzione alle licenze e ai diritti: Alcuni modelli GGUF prevedono restrizioni d'uso. Controlla la pagina di download per verificare se puoi utilizzare i file per scopi commerciali o per la ridistribuzione..
Raccomandazioni per la scelta del modello e della quantificazione più appropriati
Come hanno confermato esperti e utenti, esiste una chiara guida pratica da seguire:
Per le attività quotidiane (chat, programmazione, scrittura, richieste generali): scegliete Q4_K_M. Rappresenta il vero punto di equilibrio tra qualità e prestazioni ed è supportato da quasi tutti i framework.
Per lavori di livello avanzato o matematica complessa: Se disponete di memoria sufficiente, potete passare alla versione Q5_K_M, ma in genere la differenza di qualità sarà percepibile solo nelle attività più impegnative.
Hardware di altissima gamma? Se hai investito in una GPU di fascia alta e ti interessa la massima fedeltà grafica, puoi provare Q8_0, ma il passaggio da Q5 non è sempre giustificato, se non per benchmark o ricerca.
Risorse limitate? Prova IQ4_XS per test, prototipi rapidi o quando hai poca RAM/VRAM.
Evitate Q3/Q2 per ambienti reali o professionali., poiché "soffre" in termini di coerenza e accuratezza dei risultati.
Come GGUF contribuisce allo sviluppo e al futuro dell'IA locale e open source
Il formato GGUF non solo accelera l'adozione dell'IA sui dispositivi personali, ma democratizza anche l'accesso ai modelli avanzati . Consente a un maggior numero di persone e aziende di:
Sperimenta in prima persona i più recenti progressi nell'intelligenza artificiale generativa senza dover dipendere da grandi aziende.
Personalizza i modelli, aggiungi funzionalità e condividi versioni personalizzate con comunità o gruppi di ricerca.
Sperimenta con diverse architetture, parametri e scalabilità. senza timore di incompatibilità o blocchi
GGUF promuove inoltre lo sviluppo di nuovi strumenti, traduttori e motori, e garantisce che gli sviluppi attuali rimarranno utili per gli anni a venire grazie al suo approccio estensibile. La sua interoperabilità e la facilità di documentazione, aggregazione ed esportazione lo rendono un formato standard in repository, negozi, glossari tecnici e progetti open source.
Quali sfide e opportunità attendono GGUF?
Sebbene il formato GGUF sia già un punto di riferimento, la comunità continua a discuterne e ad apportare miglioramenti, come ad esempio:
Ottimizzazione per nuove architetture hardware (SoC per dispositivi mobili, dispositivi edge, FPGA, ecc.)
Sviluppare convertitori migliori tra framework, ad esempio da PyTorch o TensorFlow direttamente a GGUF
Maggiore automazione nella regolazione di modelli e messaggi per specifici modelli di chat o attività
Integrazione avanzata con strumenti di quantificazione, miglioramenti nei sistemi di documentazione e scoperta di modelli
Tutto ciò significherà che scaricare, personalizzare e integrare modelli di intelligenza artificiale avanzati diventerà sempre più facile, veloce ed economico , sia per le PMI che per i ricercatori, gli appassionati e le grandi piattaforme.
Il formato GGUF si è affermato come la soluzione migliore per l'esecuzione di intelligenza artificiale locale e controllata, sfruttando al meglio le risorse del computer, che si tratti di una macchina all'avanguardia o di una più modesta, e integrando facilmente i più recenti modelli LLM disponibili sul mercato. Grazie alla vasta gamma di risorse, tutorial e applicazioni compatibili, bastano pochi minuti per trovare, importare e iniziare a utilizzare modelli preconfigurati, ottimizzando tempi e costi e godendo della massima privacy e scalabilità. GGUF è fondamentale per l'apertura, la democratizzazione e il futuro dell'intelligenza artificiale applicata.