Laman Utama » Kecerdasan Buatan » Format GGUF: Apakah itu, cara ia berfungsi dan cara memanfaatkannya untuk model AI
Format GGUF: Apakah itu, cara ia berfungsi dan cara memanfaatkannya untuk model AI
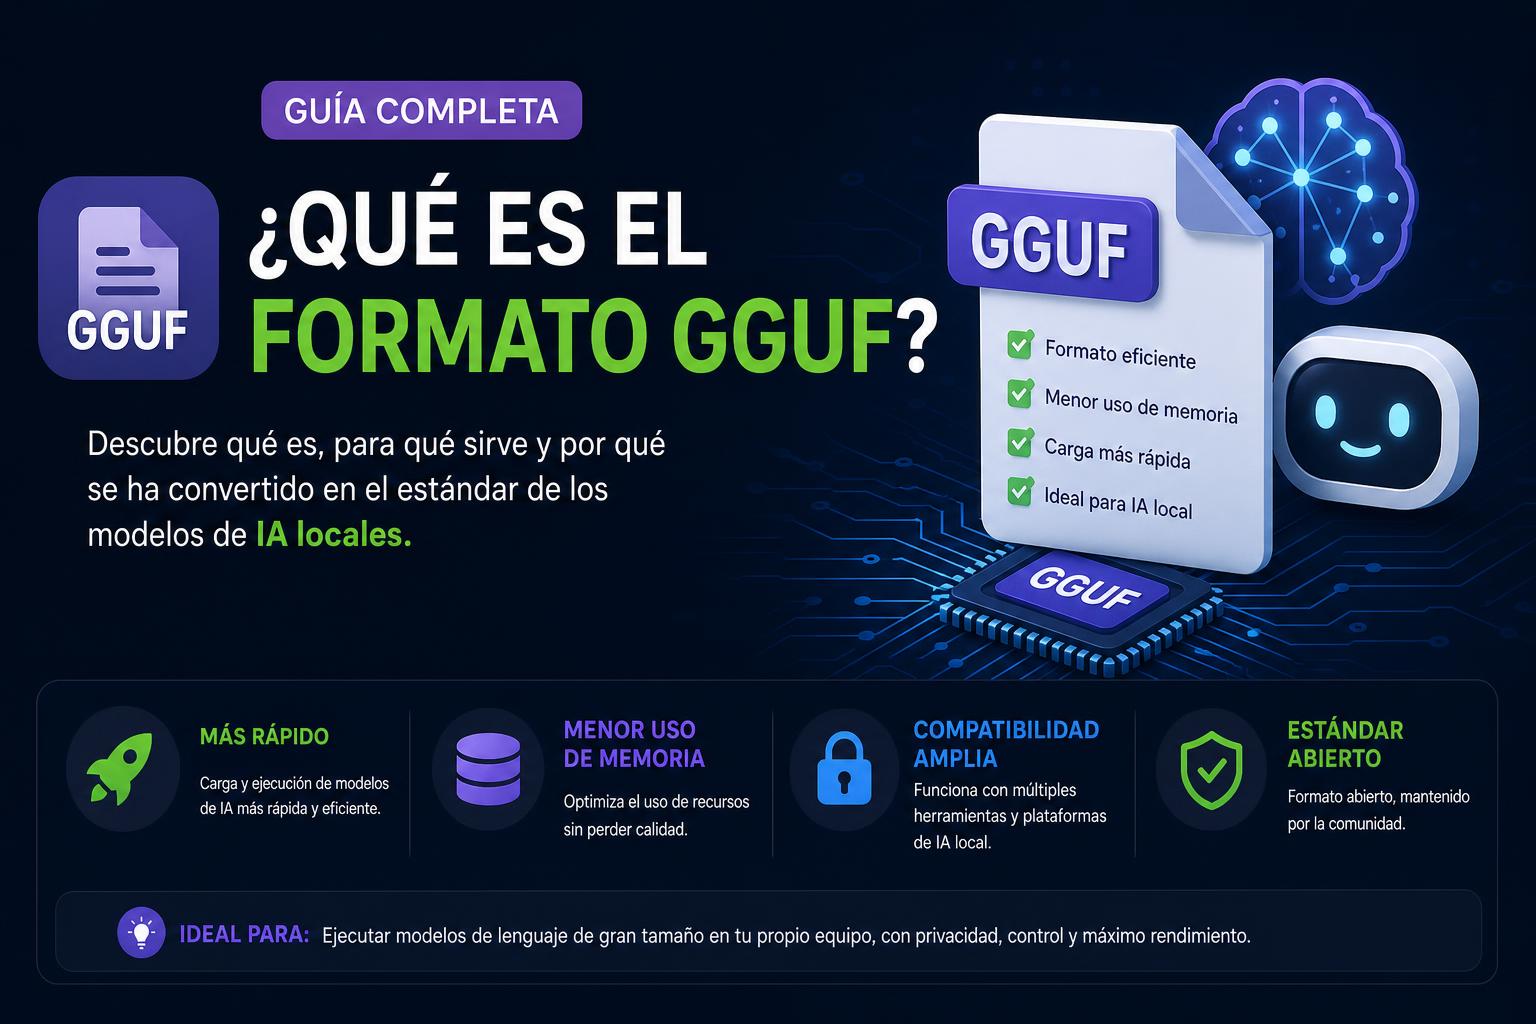
GGUF ialah format rujukan untuk berkongsi dan menjalankan model AI tempatan, mengatasi format sebelumnya dari segi fleksibiliti dan keserasian.
Tahap kuantisasinya yang berbeza membolehkan prestasi dan penggunaan sumber disesuaikan dengan perkakasan setiap pengguna, daripada peralatan sederhana hingga stesen kerja yang berkuasa.
Memuat turun dan mengimport model GGUF ke dalam aplikasi seperti Ollama, LM Studio atau AnythingLLM adalah mudah dan membolehkan anda membangunkan penyelesaian AI tersuai walaupun tanpa sambungan internet.
Komuniti besar di sekitar GGUF, dengan repositori seperti Memeluk MukaIa memudahkan untuk mencari versi, sumber dan sokongan terkini untuk pelbagai kes penggunaan.
Pernahkah anda mendengar tentang fail GGUF kebelakangan ini dan tertanya-tanya apakah itu fail GGUF dan kegunaannya ? Dunia kecerdasan buatan sedang berkembang pesat, dan format fail memainkan peranan penting dalam menjalankan model yang berkuasa, baik untuk profesional mahupun peminat yang ingin memanfaatkan sepenuhnya peralatan tempatan mereka.
Dalam artikel yang luas ini, kami akan meneroka secara mendalam semua yang berkaitan dengan format GGUF: apakah ia, untuk apa ia dicipta, bagaimana ia telah merevolusikan penggunaan model bahasa besar (LLM), kelebihannya berbanding format sebelumnya, tahap kuantisasi, tempat memuat turun model dan cara mengintegrasikannya ke dalam platform dan aplikasi AI yang berbeza.
GGUF (Format Universal GGML) ialah fail binari yang direka khusus untuk menyimpan, menyimpan dan memuatkan model kecerdasan buatan yang besar dengan cepat dan cekap, terutamanya model LLM (Model Bahasa seperti GPT, Llama, Gemma, Grok, antara lain) dan RAG (Penjanaan Semula Dipertingkat) . GGUF muncul daripada pengalaman terdahulu dengan GGML, menyesuaikan diri dengan keperluan semasa pembangun, syarikat dan komuniti: keserasian, kecekapan, fleksibiliti dan kemudahan penyepaduan merentasi platform dan aplikasi yang berbeza.
GGUF telah dibangunkan sebagai pengganti semula jadi kepada format GGML , membawakan penambahbaikan ketara yang bertindak balas terhadap permintaan yang semakin meningkat untuk perkakasan yang kurang khusus, memastikan model AI yang besar boleh digunakan bukan sahaja pada pelayan atau awan yang berkuasa, tetapi juga pada komputer desktop, komputer riba dan juga beberapa peranti mudah alih dengan sumber yang terhad.
Perbezaan dan kelebihan berbanding GGML dan format lain
Walaupun GGML sudah merupakan peningkatan yang ketara berbanding model tradisional, GGUF meningkatkan lagi standard dalam beberapa aspek utama. Mari kita lihat perbezaan dan penambahbaikan utama:
Kebolehpanjangan dan masa depan yang terjamin: GGUF direka bentuk untuk menggabungkan fungsi baharu, pilihan metadata atau parameter yang mungkin diperlukan oleh model masa hadapan, tanpa kehilangan keserasian ke belakang. Ini memudahkan kedua-dua pembangunan baharu dan alatan sedia ada mendapat manfaat daripada penambahbaikan tanpa perlu mengulang semuanya dari awal.
Fleksibiliti dalam struktur: Ia membolehkan anda mengatur data model dengan lebih cekap, menyesuaikan diri dengan seni bina dan rangka kerja yang berbeza, terutamanya untuk model AI yang baru muncul atau eksperimen.
Saling kendali dan keserasian: GGUF telah direka bentuk untuk digunakan dengan lancar dalam pelbagai persekitaran: daripada aplikasi Python atau R hinggalah enjin seperti llama.cpp, Ollama, AnythingLLM atau LM Studio. Ini membolehkan pengguna berkongsi, memuat turun dan mengimport model tanpa perlu risau tentang ketidakserasian atau perubahan dalam aliran kerja..
Saiz yang dioptimumkan dan pemuatan pantas: Disebabkan pelbagai tahap mampatan dan kuantisasi, fail GGUF menjadikan model lebih ringan dan pantas untuk dimuatkan. menjimatkan memori dan mempercepatkan inferens (respons model masa nyata).
Sokongan aktif dan komuniti: Sebagai piawaian yang terbuka dan sentiasa berkembang, terdapat komuniti besar yang mengambil bahagian dalam pembangunan format dan dalam penciptaan dan pengujian versi model baharu, dioptimumkan dan didokumenkan.
Apakah kegunaan GGUF dan apakah fungsinya?
Format GGUF digunakan terutamanya untuk menyimpan model AI dalam format yang padat, mudah alih dan sangat cekap, yang direka khusus untuk pelaksanaan setempat. Ini membolehkan anda memuat turun model pra-terlatih yang canggih (seperti GPT, Gemma, Llama, Grok, Mistral, dll.) dan menjalankannya pada komputer anda sendiri, tanpa bergantung pada perkhidmatan awan, tanpa menghantar data peribadi kepada syarikat lain dan dengan respons masa nyata yang disesuaikan dengan keperluan anda.
Keupayaan ini amat berguna untuk:
Pembangun aplikasi chatbot AI, pembantu peribadi, enjin carian pintar atau tugas pemprosesan dan analisis teks lanjutan.
Profesional yang memerlukan Privasi mutlak dalam proses AInya, memandangkan sifat tempatan model GGUF.
Orang yang ingin mengoptimumkan kos dan sumber, mengelakkan pembayaran berulang untuk API luaran atau perkhidmatan dalam talian.
Syarikat dan individu yang berminat untuk bereksperimen, memperhalusi atau bekerja dengan model AI di luar talian.
Persekitaran pendidikan dan penyelidikan di mana perkongsian model dan pelarasan antara pengguna platform yang berbeza adalah satu keutamaan.
Dari manakah datangnya GGUF dan bagaimana ia berbeza daripada format seperti PyTorch, Safetensors, GPTQ, dll.?
Keluarga format untuk model AI sangat pelbagai , tetapi setiap satunya memenuhi keperluan dan batasan yang berbeza:
PyTorch (.pth, .pt, binari, safetensor…): Ia biasanya digunakan semasa latihan atau penalaan halus dalam persekitaran pembangunan dan biasanya memerlukan perkakasan GPU sahaja yang berkuasa. Tambahan pula, ia merangkumi sejumlah besar metadata dan kod, yang meningkatkan saiz dan kerumitannya..
GGML: Ia dicipta sebagai respons untuk memudahkan inferens tempatan, tetapi telah diatasi dengan cepat oleh GGUF hasil daripada penambahbaikan yang dinyatakan di atas.
GGUF: Ia dicipta untuk merangkumi kebolehgunaan, keserasian dan kemungkinan pengemaskinian mudah berserta skema kuantisasi moden.
GPTQ, AWQ, EXL2, QLoRA, LoRA…: Kesimpulan kaedah kuantisasi dan penalaan halus Kaedah ini membolehkan pengurangan saiz model secara drastik, sambil melaraskan ketepatan dan menggunakan sumber seperti GPU atau CPU secara optimum. Banyak model GGUF dikuantitikan menggunakan kaedah ini.
Secara ringkasnya, format GGUF direka bukan sahaja untuk inferens setempat, tetapi juga untuk berkongsi model yang sedia untuk digunakan merentasi pelbagai jenis alatan dan platform, tanpa mengira sistem pengendalian atau seni bina.
Pengkuantuman dalam GGUF: Apakah maksudnya dan bagaimana ia mempengaruhi model?
Sejak kemunculan model LLM, konsep kuantisasi telah menjadi kunci: ia melibatkan pengurangan ketepatan (dalam bit) "pemberat" atau parameter dalaman model AI semasa penyimpanan atau eksport, contohnya, daripada format 16-bit (FP16) atau 32-bit kepada perwakilan 8, 5, 4, atau 2 bit yang lebih ringan. Ini bermakna model mengambil ruang yang jauh lebih sedikit, memerlukan kurang RAM, dan mengira dengan lebih pantas , sebagai pertukaran untuk sedikit kehilangan ketepatan dalam respons.
Format GGUF membawa fleksibiliti ekstrem ini ke tahap tertinggi: ia merangkumi "kuantisasi" berbilang peringkat dan serasi dengan pendekatan tradisional (untuk mencapai kualiti maksimum) dan tahap ultra-mampat yang diselaraskan kepada perkakasan terhad.
Skim kuantisasi utama dalam GGUF
Q4_K_M (atau varian Q4…): Keseimbangan ideal untuk kebanyakan pengguna: ia mengambil sedikit ruang, pantas dan kualitinya hampir sama dengan model asal dalam tugasan harian (Soal Jawab, pengaturcaraan, penulisan, ringkasan, dll.). Ini biasanya nilai lalai yang disyorkan.
Q5_K_M: Disyorkan apabila anda mencari kualiti yang lebih baik dan perkakasan anda mempunyai VRAM (memori grafik) yang mencukupi. Anda akan melihat hasil yang lebih baik dalam tugasan penaakulan yang kompleks, matematik lanjutan dan persekitaran yang mencabar.
S8_0: Perwakilan serasi berkualiti tinggi (hampir sama dengan asal yang tidak dimampatkan). Hanya disyorkan jika anda boleh mengendalikan saiz fail yang besar dan mempunyai banyak RAM/VRAM.
IQ4_XS: Format terkecil dan paling ringan yang masih boleh digunakan. Sesuai untuk ujian, eksperimen pantas atau peranti dengan VRAM yang sangat sedikit.
Elakkan Q3 dan Q2 jika anda mahukan kualiti: Kehilangan ketepatan biasanya sangat ketara dan ia hanya berguna dalam persekitaran yang sangat terhad atau untuk tugasan tertentu.
Tahap kuantifikasi: perbandingan dan kes penggunaan
Tahap yang mana hendak dipilih? Di sinilah format GGUF menonjol dengan fleksibilitinya. Bergantung pada keperluan anda, anda boleh memilih:
Pengkuantuman 2-bit: Saiz minimum, mampatan maksimumDigunakan dalam peranti yang sangat terhad, tetapi kehilangan kualiti boleh menjadi tinggi.
Pengkuantuman 4-bit: Mampatan dan kelajuan yang sangat unggul dengan hampir tiada kehilangan kualiti untuk tugasan biasa. Penyelesaian pilihan untuk ramai pembangun.
Pengkuantuman 8-bit: Hampir ketepatan maksimum dan hampir tiada mampatan berbanding dengan fail asal yang tidak diproses.
Dengan menggabungkan ini dengan kaedah yang berbeza (GPTQ, AWQ, QLoRA, dll.), GGUF membolehkan model yang sama digunakan dengan "perisa" yang berbeza, menyesuaikan diri dengan setiap kes penggunaan dan perkakasan yang tersedia.
Apakah kelebihan praktikal yang ditawarkan oleh GGUF kepada pengguna dan syarikat?
Pengecasan ultra-pantas: Disebabkan format binari dan strukturnya yang cekap, model boleh dimuatkan dalam beberapa saat, yang penting untuk aplikasi dan perkhidmatan yang sensitif masa atau kerap dikemas kini.
Kemudahalihan dan penyeragaman: Berkongsi, menyalin dan memasang model GGUF semudah memindahkan satu fail, tanpa sebarang kebergantungan atau masalah pemformatan versi.
Keserasian: Ia berintegrasi dengan pelbagai jenis rangka kerja (Python, R, CUDA, dll.) dan aplikasi (daripada Ollama hingga AnythingLLM, LM Studio atau chatbot tersuai).
Penggunaan tenaga yang dikurangkan: Model terkuantum GGUF, dengan memerlukan sumber yang lebih sedikit, membantu mengurangkan bil elektrik dan jejak karbon perkakasan, turut memudahkan penggunaannya dalam peranti pinggir atau penyelesaian mudah alih.
Naik taraf dan kebolehskalaan: Menggabungkan jenis data atau parameter baharu adalah mudah, jadi GGUF bersedia untuk kemajuan masa hadapan dalam sektor AI.
Di mana saya boleh memuat turun fail GGUF dan bagaimana saya mengintegrasikannya ke dalam projek saya?
Sumber utama dan paling popular bagi model GGUF ialah bahagian Fail GGUF pada Hugging Face . Di sana anda boleh menapis, mencari dan memuat turun beribu-ribu model LLM percuma dan varian RAG terkuantum pada tahap berbeza, sedia untuk kegunaan setempat.
Selain Hugging Face, sesetengah aplikasi membenarkan anda memuat turun model daripada antara muka mereka sendiri atau memindahkan dan mengurusnya daripada direktori setempat, mengeksport atau mengimportnya ke aplikasi lain (seperti LM Studio, AnythingLLM atau Chatbox).
Cara mengimport fail GGUF yang dimuat turun ke Ollama
Muat turun model GGUF: Pilih tahap kuantisasi yang paling sesuai dengan perkakasan anda dan simpannya ke folder setempat.
Cipta fail Model: Dalam direktori yang sama, cipta fail (contohnya, “Modelfile”) dengan baris FROM yang menghala ke nama sebenar fail .gguf anda. Ini memberitahu Ollama dari mana hendak memuatkan model tersebut.
Muatkan model ke dalam Ollama: Jalankan arahan yang sesuai untuk mengimport model menggunakan pilihan “-f Modelfile”. Contoh: ollama create myModelName -f Modelfile
Jalankan model: Anda kini boleh menggunakan model setempat seolah-olah anda telah memuat turunnya daripada pustaka standard.
Proses ini sangat serupa untuk LM Studio, AnythingLLM dan aplikasi lain yang serasi dengan GGUF.
Sebaliknya, jika versi rasmi model sudah wujud dalam pustaka platform anda, lebih mudah untuk menggunakan arahan "tarik" yang sepadan, tetapi import manual adalah kunci jika anda memerlukan varian kuantisasi tertentu, model yang luar biasa atau jika anda lebih suka kawalan yang lebih besar ke atas tempat dan cara model disimpan.
Aplikasi yang serasi dan kegunaan utama fail GGUF di dunia sebenar
Ekosistem GGUF kini sangat luas. Lihat projek utama dan kes penggunaannya:
Ollama: Membolehkan anda mengimport model luaran, mencipta model anda sendiri dan bereksperimen dengan tetapan kuantisasi dan templat tersuai.
LM StudioIa termasuk antara muka grafik yang sangat mudah untuk mencari, memuat turun dan memasang model GGUF, serta mengeksportnya ke aplikasi lain atau merujuknya melalui API tempatan.
Apa-apaLLM y JanPenyelesaian desktop dan perusahaan untuk menggunakan chatbot AI tempatan, dengan sokongan penuh untuk model GGUF dan templat pra-latihan.
3DIMLIGlosari dan kedai teknikal yang menawarkan model atau bahan tertentu dalam GGUF, dengan cadangan tentang cara mendokumentasikan versi dan keserasian dengan betul untuk setiap kes.
Projek sumber terbuka dan persekitaran penyelidikan, hasil daripada kebolehkendalian dengan Python dan R.
Di samping itu, beberapa platform profesional dan komersial mula menawarkan templat siap pakai dalam GGUF untuk mempercepatkan penggunaan dan penyepaduan penyelesaian AI termaju.
Penjagaan dan petua praktikal semasa bekerja dengan fail GGUF
Sentiasa periksa keserasian: Sebelum memuat turun sebarang fail GGUF, pastikan ia serasi dengan aplikasi anda (versi khusus Ollama, LM Studio, dsb.) dan perkakasan anda. Jika model tersebut memerlukan versi enjin tertentu, semak nota tersebut di laman web sumber..
Namakan dan susun fail dengan teliti: Oleh kerana sesetengah proses sensitif huruf besar/kecil, gunakan nama yang mudah dan jelas untuk mengelakkan ralat pemuatan.
Sesuaikan kuantifikasi dengan pasukan anda: Walaupun anda boleh mengimport model Q8 atau Q5, jika VRAM anda terhad, lebih baik memilih Q4 atau IQ4, sekali gus mengelakkan penguncian sumber.
Sesuaikan templat jika anda mencipta chatbot: Apabila mengimport model sembang, mungkin perlu melaraskan templat gesaan dalam Fail Model atau tetapan untuk mencapai respons yang lebih stabil dan semula jadi.
Perhatian kepada lesen dan hak: Sesetengah model GGUF menambah sekatan penggunaan. Semak halaman muat turun untuk melihat sama ada anda boleh menggunakannya untuk tujuan komersial atau untuk pengedaran semula..
Cadangan untuk memilih model dan kuantifikasi yang betul
Seperti yang telah disahkan oleh pakar dan pengguna, terdapat panduan praktikal yang jelas untuk diikuti:
Untuk tugasan harian (bersembang, pengaturcaraan, penulisan, pertanyaan umum): pilih Q4_K_M. Ia merupakan "sweet spot" sebenar dalam kualiti/prestasi dan disokong oleh hampir semua rangka kerja.
Untuk kerja lanjutan atau matematik kompleks: Jika anda mempunyai memori yang mencukupi, tingkatkan kepada Q5_K_M, tetapi biasanya perbezaan kualiti hanya akan ketara dalam tugasan yang mencabar.
Perkakasan tercanggih? Jika anda telah melabur dalam GPU yang besar dan berminat dengan ketepatan maksimum, anda boleh mencuba Q8_0, tetapi lonjakan daripada Q5 tidak selalunya wajar kecuali dalam penanda aras atau penyelidikan.
Sumber terhad? Cuba IQ4_XS untuk ujian, prototaip pantas atau apabila anda benar-benar kekurangan RAM/VRAM.
Elakkan Suku Ketiga/Suku Kedua untuk persekitaran dunia sebenar atau profesional, kerana ia "menderita" dari segi koheren dan ketepatan keputusan.
Bagaimana GGUF menyumbang kepada pembangunan dan masa depan AI tempatan dan sumber terbuka
Format GGUF bukan sahaja mempercepatkan penggunaan AI pada peranti peribadi, tetapi juga mendemokrasikan akses kepada model canggih . Ia membolehkan lebih ramai orang dan perniagaan untuk:
Alami kemajuan terkini dalam AI generatif secara langsung tanpa perlu bergantung pada syarikat besar
Sesuaikan model, tambahkan ciri dan kongsikan versi tersuai dengan komuniti atau kumpulan penyelidikan.
Bereksperimen dengan seni bina, parameter dan kebolehskalaan yang berbeza tanpa rasa takut akan ketidakserasian atau sekatan
GGUF juga menggalakkan pembangunan alatan, penterjemah dan enjin baharu, dan memastikan bahawa perkembangan semasa akan kekal berguna untuk tahun-tahun akan datang hasil daripada pendekatannya yang boleh diperluas. Kebolehkendaliannya yang saling beroperasi dan kemudahan dokumentasi, penggabungan dan eksport menjadikannya format standard dalam repositori, stor, glosari teknikal dan projek komuniti terbuka.
Apakah cabaran dan peluang yang bakal dihadapi oleh GGUF?
Walaupun format GGUF sudah menjadi penanda aras, komuniti terus berdebat dan menambah penambahbaikan seperti:
Pengoptimuman untuk seni bina perkakasan baharu (SoC mudah alih, peranti pinggir, FPGA, dll.)
Membangunkan penukar yang lebih baik antara rangka kerja, contohnya dari PyTorch atau TensorFlow terus ke GGUF
Automasi yang lebih baik dalam melaraskan templat dan gesaan untuk model atau tugasan sembang tertentu
Integrasi lanjutan dengan alat kuantifikasi, penambahbaikan dalam sistem dokumentasi dan penemuan model
Semua ini bermakna memuat turun, menyesuaikan dan mengintegrasikan model AI termaju akan menjadi semakin mudah, pantas dan lebih berpatutan untuk PKS, penyelidik, peminat dan platform besar.
Format GGUF telah mengukuhkan kedudukannya sebagai penyelesaian terbaik untuk menjalankan kecerdasan buatan tempatan yang terkawal, memanfaatkan sumber komputer anda dengan cemerlang, sama ada mesin canggih atau yang lebih sederhana, dan mengintegrasikan model LLM terkini di pasaran dengan mudah. Dengan pelbagai sumber, tutorial dan aplikasi serasi yang tersedia, hanya memerlukan beberapa minit untuk mencari, mengimport dan mula menggunakan model sedia ada, mengoptimumkan masa dan kos sambil menikmati privasi dan skalabiliti maksimum. GGUF adalah kunci kepada keterbukaan, pendemokrasian dan masa depan kecerdasan buatan praktikal.