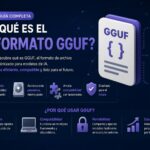
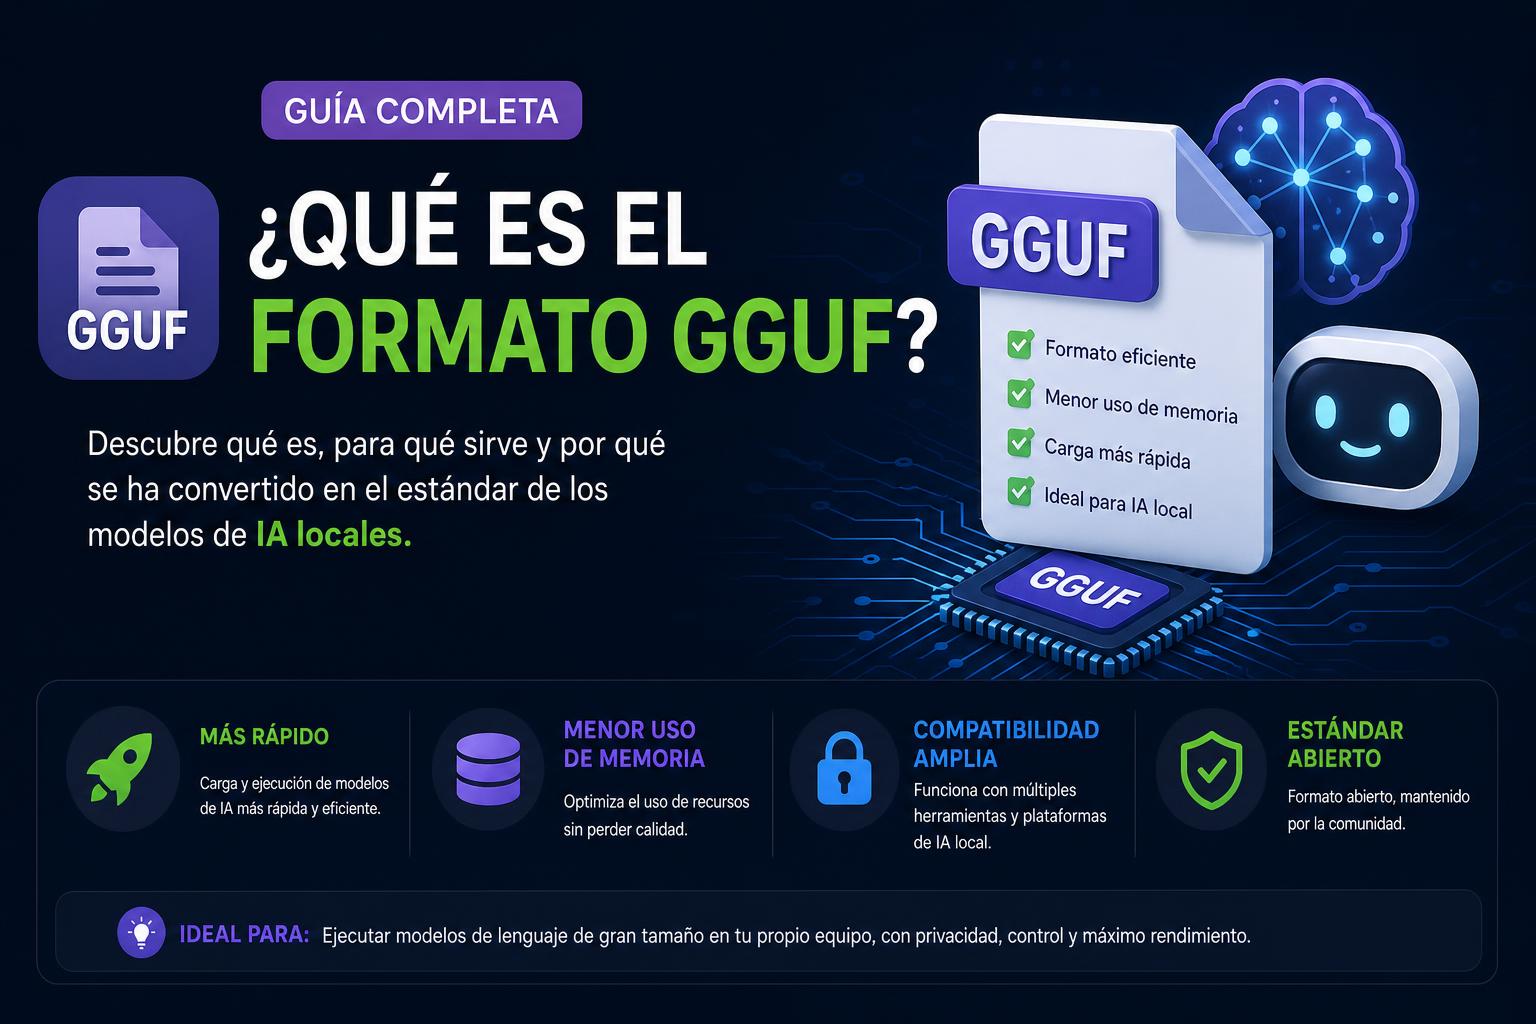
- GGUF เป็นรูปแบบมาตรฐานสำหรับการแชร์และใช้งานโมเดล AI ในเครื่อง ซึ่งมีความยืดหยุ่นและเข้ากันได้ดีกว่ารูปแบบก่อนหน้า
- ระดับการควอนไทเซชันที่แตกต่างกันช่วยให้สามารถปรับประสิทธิภาพและการใช้ทรัพยากรให้เหมาะสมกับฮาร์ดแวร์ของผู้ใช้แต่ละคน ตั้งแต่อุปกรณ์ธรรมดาไปจนถึงเวิร์กสเตชันประสิทธิภาพสูง
- การดาวน์โหลดและนำเข้าโมเดล GGUF ลงในแอปพลิเคชันต่างๆ เช่น Ollama, LM Studio หรือ AnythingLLM นั้นง่ายดาย และช่วยให้คุณสามารถพัฒนาโซลูชัน AI แบบกำหนดเองได้แม้ไม่มีการเชื่อมต่ออินเทอร์เน็ต
- ชุมชนขนาดใหญ่รอบ ๆ GGUF พร้อมด้วยคลังเก็บข้อมูลต่างๆ เช่น กอดหน้าทำให้ง่ายต่อการค้นหาเวอร์ชันล่าสุด แหล่งข้อมูล และการสนับสนุนสำหรับกรณีการใช้งานต่างๆ
คุณเคยได้ยินเกี่ยวกับไฟล์ GGUF บ้างไหม และสงสัยว่ามันคืออะไรและใช้ทำอะไร ? โลกของปัญญาประดิษฐ์กำลังก้าวหน้าอย่างรวดเร็ว และรูปแบบไฟล์มีบทบาทสำคัญในการใช้งานโมเดลที่มีประสิทธิภาพ ทั้งสำหรับมืออาชีพและผู้ที่ชื่นชอบที่ต้องการใช้ประโยชน์จากอุปกรณ์ของตนให้มากที่สุด
ในบทความฉบับนี้ เราจะเจาะลึกทุกสิ่งทุกอย่างที่เกี่ยวข้องกับรูปแบบ GGUF: GGUF คืออะไร สร้างขึ้นมาเพื่ออะไร GGUF ปฏิวัติการใช้งานโมเดลภาษาขนาดใหญ่ (LLM) อย่างไร ข้อดีของ GGUF เมื่อเทียบกับรูปแบบก่อนหน้า ระดับการควอนไทเซชัน แหล่งดาวน์โหลดโมเดล และวิธีการผสานรวมเข้ากับแพลตฟอร์มและแอปพลิเคชัน AI ต่างๆ
ดัชนี
- 1 ไฟล์ GGUF คืออะไรกันแน่?
- 2 ความแตกต่างและข้อดีเมื่อเปรียบเทียบกับ GGML และรูปแบบอื่นๆ
- 3 GGUF ใช้ทำอะไร และช่วยให้คุณทำอะไรได้บ้าง?
- 4 GGUF มีที่มาอย่างไร และแตกต่างจากรูปแบบอื่นๆ เช่น PyTorch, Safetensors, GPTQ อย่างไร?
- 5 การควอนไทเซชันใน GGUF: หมายความว่าอย่างไร และส่งผลต่อโมเดลอย่างไร?
- 6 ระดับของการวัดเชิงปริมาณ: การเปรียบเทียบและกรณีศึกษา
- 7 GGUF มีข้อดีในทางปฏิบัติอะไรบ้างสำหรับผู้ใช้และบริษัทต่างๆ?
- 8 ฉันสามารถดาวน์โหลดไฟล์ GGUF ได้จากที่ไหน และฉันจะนำไปใช้ในโปรเจ็กต์ของฉันได้อย่างไร?
- 9 แอปพลิเคชันที่เข้ากันได้และการใช้งานจริงหลักของไฟล์ GGUF
- 10 ข้อควรระวังและเคล็ดลับในการใช้งานไฟล์ GGUF
- 11 คำแนะนำสำหรับการเลือกแบบจำลองและการวัดปริมาณที่เหมาะสม
- 12 GGUF มีส่วนร่วมอย่างไรในการพัฒนาและอนาคตของ AI ในระดับท้องถิ่นและแบบโอเพนซอร์ส
- 13 GGUF เผชิญกับความท้าทายและโอกาสอะไรบ้างในอนาคต?
ไฟล์ GGUF คืออะไรกันแน่?
GGUF ( GGML Universal Format) เป็นไฟล์ไบนารีที่ออกแบบมาโดยเฉพาะเพื่อจัดเก็บ บันทึก และโหลดโมเดลปัญญาประดิษฐ์ขนาดใหญ่ได้อย่างรวดเร็วและมีประสิทธิภาพ โดยเฉพาะอย่างยิ่งโมเดลLLM (Language Models เช่น GPT, Llama, Gemma, Grok และอื่นๆ) และโมเดล RAG (Retrieval Augmented Generation) GGUF พัฒนามาจากประสบการณ์ก่อนหน้านี้ของ GGML โดยปรับให้เข้ากับความต้องการในปัจจุบันของนักพัฒนา บริษัท และชุมชน ได้แก่ ความเข้ากันได้ ประสิทธิภาพ ความยืดหยุ่น และความง่ายในการบูรณาการข้ามแพลตฟอร์มและแอ ปพลิเคชันต่างๆ
GGUF ได้รับการพัฒนาขึ้นมาเพื่อสืบทอดรูปแบบ GGML อย่างเป็นธรรมชาติ โดยนำมาซึ่งการปรับปรุงที่โดดเด่นซึ่งตอบสนองความต้องการที่เพิ่มขึ้นสำหรับฮาร์ดแวร์ที่มีความเชี่ยวชาญน้อยลง ทำให้มั่นใจได้ว่าโมเดล AI ขนาดใหญ่สามารถใช้งานได้ไม่เพียงแต่บนเซิร์ฟเวอร์หรือคลาวด์ที่มีประสิทธิภาพสูงเท่านั้น แต่ยังสามารถใช้งานได้บนคอมพิวเตอร์เดสก์ท็อป แล็ปท็อป และแม้แต่บนอุปกรณ์พกพาบางรุ่นที่มีทรัพยากรจำกัดอีกด้วย
ความแตกต่างและข้อดีเมื่อเปรียบเทียบกับ GGML และรูปแบบอื่นๆ
แม้ว่า GGML จะเป็นการพัฒนาที่สำคัญกว่าโมเดลแบบดั้งเดิมอยู่แล้ว แต่GGUF ก็ยกระดับมาตรฐานขึ้นไปอีกในหลายแง่มุมที่สำคัญ มาดูกันว่าความแตกต่างและการปรับปรุงหลักๆ มีอะไรบ้าง:
- ความยืดหยุ่นและความมั่นคงในอนาคต: GGUF ได้รับการออกแบบมาเพื่อรองรับฟังก์ชันการทำงานใหม่ ตัวเลือกเมตาเดต้า หรือพารามิเตอร์ที่โมเดลในอนาคตอาจต้องการ โดยไม่สูญเสียความเข้ากันได้กับเวอร์ชันก่อนหน้า これによりทั้งการพัฒนาใหม่ๆ และเครื่องมือที่มีอยู่เดิมจะได้รับประโยชน์จากการปรับปรุงได้ง่ายขึ้น โดยไม่ต้องเริ่มต้นใหม่ทั้งหมดตั้งแต่ต้น
- ความยืดหยุ่นในโครงสร้าง: ช่วยให้คุณจัดการข้อมูลโมเดลได้อย่างมีประสิทธิภาพมากขึ้น ปรับให้เข้ากับสถาปัตยกรรมและเฟรมเวิร์กต่างๆ โดยเฉพาะอย่างยิ่งสำหรับโมเดล AI ที่กำลังพัฒนาหรืออยู่ในขั้นตอนทดลอง
- การทำงานร่วมกันและความเข้ากันได้: GGUF ได้รับการออกแบบมาให้ใช้งานได้อย่างราบรื่นในสภาพแวดล้อมที่หลากหลาย ตั้งแต่แอปพลิเคชัน Python หรือ R ไปจนถึงเครื่องมือต่างๆ เช่น llama.cpp, Ollama, AnythingLLM หรือ LM Studio これによりผู้ใช้สามารถแชร์ ดาวน์โหลด และนำเข้าโมเดลได้โดยไม่ต้องกังวลเกี่ยวกับปัญหาความเข้ากันไม่ได้หรือการเปลี่ยนแปลงขั้นตอนการทำงาน.
- ขนาดที่เหมาะสมและการโหลดที่รวดเร็ว: ด้วยเทคโนโลยีการบีบอัดและการกำหนดปริมาณข้อมูลหลายระดับ ไฟล์ GGUF จึงทำให้โมเดลมีขนาดเล็กลงและโหลดได้เร็วขึ้นมาก ช่วยประหยัดหน่วยความจำและเพิ่มความเร็วในการประมวลผล (การตอบสนองของโมเดลแบบเรียลไทม์).
- การสนับสนุนและการมีส่วนร่วมอย่างแข็งขันจากชุมชน: เนื่องจากเป็นมาตรฐานแบบเปิดและมีการพัฒนาอย่างต่อเนื่อง จึงมีชุมชนขนาดใหญ่ที่เข้าร่วมทั้งในการพัฒนาฟอร์แมตและการสร้างและทดสอบโมเดลเวอร์ชันใหม่ที่ได้รับการปรับปรุงให้เหมาะสมและมีเอกสารประกอบอย่างครบถ้วน
GGUF ใช้ทำอะไร และช่วยให้คุณทำอะไรได้บ้าง?
รูปแบบไฟล์ GGUF ใช้สำหรับจัดเก็บโมเดล AI ในรูปแบบที่กะทัดรัด พกพาได้ และมีประสิทธิภาพสูง โดยเฉพาะอย่างยิ่งออกแบบมาสำหรับการใช้งานในเครื่องทำให้คุณสามารถดาวน์โหลดโมเดลที่ผ่านการฝึกฝนล่วงหน้าและทันสมัย (เช่น GPT, Gemma, Llama, Grok, Mistral เป็นต้น) และเรียกใช้งานบนคอมพิวเตอร์ของคุณเองได้ โดยไม่ต้องพึ่งพาบริการคลาวด์ ไม่ต้องส่งข้อมูลส่วนบุคคลไปยังบริษัทอื่น และได้รับการตอบสนองแบบเรียลไทม์ที่ปรับให้เหมาะกับความต้องการของคุณ
ความสามารถนี้มีประโยชน์อย่างยิ่งสำหรับ:
- นักพัฒนาแอปพลิเคชันแชทบอท AI, ผู้ช่วยส่วนตัว, เครื่องมือค้นหาอัจฉริยะ หรือแอปพลิเคชันประมวลผลและวิเคราะห์ข้อความขั้นสูง
- ผู้เชี่ยวชาญที่ต้องการ ความเป็นส่วนตัว มีความสมบูรณ์แบบในกระบวนการ AI เนื่องจากลักษณะเฉพาะของโมเดล GGUF ที่เป็นแบบเฉพาะพื้นที่
- ผู้ที่ต้องการเพิ่มประสิทธิภาพด้านต้นทุนและทรัพยากร โดยหลีกเลี่ยงการชำระเงินซ้ำซ้อนสำหรับ API ภายนอกหรือบริการออนไลน์
- บริษัทและบุคคลที่สนใจทดลอง ปรับแต่ง หรือใช้งานโมเดล AI แบบออฟไลน์
- สภาพแวดล้อมทางการศึกษาและการวิจัยที่ให้ความสำคัญกับการแบ่งปันแบบจำลองและการปรับเปลี่ยนระหว่างผู้ใช้แพลตฟอร์มต่างๆ
GGUF มีที่มาอย่างไร และแตกต่างจากรูปแบบอื่นๆ เช่น PyTorch, Safetensors, GPTQ อย่างไร?
รูปแบบไฟล์สำหรับโมเดล AI มีความหลากหลายมากแต่ละรูปแบบตอบสนองความต้องการและข้อจำกัดที่แตกต่างกัน:
- PyTorch (.pth, .pt, ไฟล์ไบนารี, safetensor…) โดยทั่วไปแล้วจะใช้ในระหว่างการฝึกอบรมหรือการปรับแต่งในสภาพแวดล้อมการพัฒนา และมักต้องการฮาร์ดแวร์ GPU ที่ทรงพลังเท่านั้น นอกจากนี้ ไฟล์เหล่านี้ยังประกอบด้วยเมตาเดตาและโค้ดจำนวนมาก ซึ่งทำให้ขนาดและความซับซ้อนของไฟล์เพิ่มขึ้น.
- GGML: มันถูกสร้างขึ้นเพื่อตอบสนองความต้องการในการอนุมานในระดับท้องถิ่น แต่ก็ถูก GGUF แซงหน้าไปอย่างรวดเร็วด้วยการปรับปรุงต่างๆ ที่กล่าวมาข้างต้น
- GGUF: มันถูกสร้างขึ้นเพื่อรองรับการพกพา ความเข้ากันได้ และความเป็นไปได้ในการอัปเดตได้ง่าย พร้อมกับรูปแบบการควอนไทเซชันที่ทันสมัย
- GPTQ, AWQ, EXL2, QLoRA, LoRA...: บุตรชาย วิธีการควอนไทเซชันและการปรับแต่งอย่างละเอียด วิธีการเหล่านี้ช่วยลดขนาดของโมเดลลงได้อย่างมาก ในขณะเดียวกันก็ปรับความแม่นยำและใช้ทรัพยากรต่างๆ เช่น GPU หรือ CPU ได้อย่างเหมาะสมที่สุด โมเดล GGUF จำนวนมากถูกแปลงเป็นโมเดลเชิงปริมาณโดยใช้วิธีการเหล่านี้
โดยสรุปแล้วรูปแบบ GGUFได้รับการออกแบบไม่เพียงแต่สำหรับการอนุมานในระดับท้องถิ่นเท่านั้น แต่ยังรวมถึงการแบ่งปันโมเดลที่พร้อมใช้งานในเครื่องมือและแพลตฟอร์มที่หลากหลาย โดยไม่คำนึงถึงระบบปฏิบัติการหรือสถาปัตยกรรม
การควอนไทเซชันใน GGUF: หมายความว่าอย่างไร และส่งผลต่อโมเดลอย่างไร?
นับตั้งแต่การเกิดขึ้นของโมเดล LLM แนวคิดเรื่องการลดความละเอียด (quantization)ได้กลายเป็นสิ่งสำคัญ: มันเกี่ยวข้องกับการลดความแม่นยำ (ในหน่วยบิต) ของ "น้ำหนัก" หรือพารามิเตอร์ภายในของโมเดล AI ในระหว่างการบันทึกหรือส่งออก โดยเปลี่ยนจากรูปแบบ 16 บิต (FP16) หรือแม้แต่ 32 บิต ไปเป็นรูปแบบที่เบากว่ามาก เช่น 8, 5, 4 หรือแม้แต่ 2 บิตซึ่งหมายความว่าโมเดลจะใช้พื้นที่น้อยลง ต้องการ RAM น้อยลง และคำนวณได้เร็วขึ้นมากแลกกับการสูญเสียความแม่นยำในการตอบสนองเล็กน้อย
รูปแบบ GGUF นำความยืดหยุ่นขั้นสุดยอดนี้ไปสู่ระดับสูงสุด: มันรวม "การกำหนดปริมาณ" หลายระดับ และเข้ากันได้กับทั้งวิธีการแบบดั้งเดิม (เพื่อให้ได้คุณภาพสูงสุด) และระดับการบีบอัดสูงพิเศษที่ปรับให้เข้ากับฮาร์ดแวร์ที่มีข้อจำกัด
รูปแบบการควอนไทเซชันหลักใน GGUF
- Q4_K_M (หรือรูปแบบต่างๆ ของ Q4…) เป็นการผสมผสานที่ลงตัวสำหรับผู้ใช้ส่วนใหญ่: ใช้พื้นที่น้อย ทำงานได้เร็ว และคุณภาพเกือบจะเหมือนกับรุ่นดั้งเดิมในการใช้งานทั่วไป (ถาม-ตอบ, การเขียนโปรแกรม, การเขียน, การสรุป ฯลฯ) โดยปกติแล้วนี่คือค่าเริ่มต้นที่แนะนำ.
- Q5_K_M: แนะนำสำหรับผู้ที่ต้องการคุณภาพที่ดีกว่า และฮาร์ดแวร์ของคุณมี VRAM (หน่วยความจำกราฟิก) เพียงพอ คุณจะสังเกตเห็นผลลัพธ์ที่ดีขึ้นในงานที่ต้องใช้เหตุผลซับซ้อน คณิตศาสตร์ขั้นสูง และสภาพแวดล้อมที่ต้องการประสิทธิภาพสูง
- Q8_0: รูปแบบการแสดงผลที่เข้ากันได้คุณภาพสูงสุด (เกือบเหมือนกับต้นฉบับที่ไม่ได้บีบอัด) แนะนำเฉพาะในกรณีที่คุณสามารถรับมือกับขนาดไฟล์ขนาดใหญ่และมี RAM/VRAM เหลือเฟือเท่านั้น.
- IQ4_XS: รูปแบบที่เล็กที่สุดและเบาที่สุดที่ยังคงใช้งานได้ เหมาะอย่างยิ่งสำหรับการทดสอบ การทดลองอย่างรวดเร็ว หรืออุปกรณ์ที่มี VRAM น้อยมาก.
- ถ้าคุณกำลังมองหาสินค้าคุณภาพดี ควรหลีกเลี่ยงสินค้าในไตรมาสที่ 3 และ 2: การสูญเสียความแม่นยำมักสังเกตเห็นได้ชัดเจน และมีประโยชน์เฉพาะในสภาพแวดล้อมที่จำกัดมาก หรือสำหรับงานเฉพาะบางอย่างเท่านั้น
ระดับของการวัดเชิงปริมาณ: การเปรียบเทียบและกรณีศึกษา
ควรเลือกระดับไหนดี? นี่คือจุดเด่นของรูปแบบ GGUF ที่มีความหลากหลาย ขึ้นอยู่กับความต้องการของคุณ คุณสามารถเลือกได้ดังนี้:
- การควอนไทเซชัน 2 บิต: ขนาดขั้นต่ำ การบีบอัดสูงสุดใช้ในอุปกรณ์จำนวนจำกัดมาก แต่คุณภาพอาจลดลงอย่างมาก
- การควอนไทเซชัน 4 บิต: ประสิทธิภาพการบีบอัดและการทำงานที่รวดเร็วเป็นเลิศ โดยแทบไม่มีการสูญเสียคุณภาพสำหรับการใช้งานทั่วไป เป็นโซลูชันที่นักพัฒนาหลายคนเลือกใช้.
- การควอนไทเซชัน 8 บิต: คุณภาพเสียงคมชัดเกือบสูงสุด และแทบไม่มีการบีบอัดเมื่อเทียบกับไฟล์ต้นฉบับที่ยังไม่ผ่านการประมวลผล
ด้วยการผสานรวมสิ่งนี้เข้ากับวิธีการต่างๆ (GPTQ, AWQ, QLoRA เป็นต้น) GGUF จึงอนุญาตให้ใช้งานโมเดลเดียวกันได้ในรูปแบบที่แตกต่างกัน ปรับให้เข้ากับกรณีการใช้งานและฮาร์ดแวร์ที่มีอยู่
GGUF มีข้อดีในทางปฏิบัติอะไรบ้างสำหรับผู้ใช้และบริษัทต่างๆ?
- การชาร์จที่รวดเร็วเป็นพิเศษ: ด้วยรูปแบบไบนารีและโครงสร้างที่มีประสิทธิภาพ ทำให้สามารถโหลดโมเดลได้ในเวลาเพียงไม่กี่วินาที ซึ่งเป็นสิ่งสำคัญสำหรับแอปพลิเคชันและบริการที่ต้องการความรวดเร็วหรือมีการอัปเดตบ่อยครั้ง
- ความสะดวกในการพกพาและการกำหนดมาตรฐาน: การแชร์ คัดลอก และติดตั้งโมเดล GGUF นั้นง่ายเหมือนกับการย้ายไฟล์เพียงไฟล์เดียว โดยไม่มีปัญหาเรื่องการพึ่งพาหรือการกำหนดเวอร์ชัน
- ความเข้ากันได้: มันสามารถผสานรวมกับเฟรมเวิร์ก (Python, R, CUDA ฯลฯ) และแอปพลิเคชันที่หลากหลาย (ตั้งแต่ Ollama ไปจนถึง AnythingLLM, LM Studio หรือแชทบอทที่กำหนดเอง)
- ลดการใช้พลังงาน: โมเดลควอนตัมของ GGUF ต้องการทรัพยากรน้อยกว่า จึงช่วยลดค่าไฟฟ้าและปริมาณการปล่อยก๊าซคาร์บอนไดออกไซด์ของฮาร์ดแวร์ อีกทั้งยังช่วยให้สามารถใช้งานในอุปกรณ์ปลายทางหรือโซลูชันมือถือได้ง่ายขึ้น
- การอัปเกรดและความสามารถในการขยายระบบ: การนำข้อมูลหรือพารามิเตอร์ประเภทใหม่มาใช้ไม่ใช่เรื่องยาก ดังนั้น GGUF จึงพร้อมรับมือกับความก้าวหน้าในอนาคตของภาคส่วน AI
ฉันสามารถดาวน์โหลดไฟล์ GGUF ได้จากที่ไหน และฉันจะนำไปใช้ในโปรเจ็กต์ของฉันได้อย่างไร?
แหล่งที่มาหลักและเป็นที่นิยมที่สุดของโมเดล GGUFคือส่วน GGUF Files บนเว็บไซต์ Hugging Faceที่นั่นคุณสามารถกรอง ค้นหา และดาวน์โหลดโมเดล LLM และโมเดล RAG ที่ปรับแต่งแล้วหลายพันแบบในระดับต่างๆ ได้ฟรี พร้อมใช้งานในเครื่องของคุณ
นอกจาก Hugging Face แล้ว แอปพลิเคชันบางตัวยังอนุญาตให้คุณดาวน์โหลดโมเดลจากอินเทอร์เฟซของแอปนั้นๆ หรือแม้แต่ถ่ายโอนและจัดการโมเดลจากไดเร็กทอรีในเครื่อง โดยส่งออกหรือนำเข้าโมเดลไปยังแอปอื่นๆ (เช่น LM Studio, AnythingLLM หรือ Chatbox)
วิธีการนำเข้าไฟล์ GGUF ที่ดาวน์โหลดมาลงใน Ollama
- ดาวน์โหลดโมเดล GGUF: เลือกค่าระดับการควอนไทเซชันที่เหมาะสมที่สุดกับฮาร์ดแวร์ของคุณ แล้วบันทึกไว้ในโฟลเดอร์ในเครื่อง
- สร้างไฟล์โมเดล: ในไดเร็กทอรีเดียวกัน ให้สร้างไฟล์ (ตัวอย่างเช่น “Modelfile”) โดยเพิ่มบรรทัด FROM ที่ชี้ไปยังชื่อไฟล์ .gguf จริงของคุณ วิธีนี้จะบอก Ollama ว่าจะโหลดโมเดลจากที่ใด
- โหลดโมเดลลงใน Ollama: เรียกใช้คำสั่งที่เหมาะสมเพื่อนำเข้าโมเดลโดยใช้ตัวเลือก “-f Modelfile” ตัวอย่าง:
ollama create myModelName -f Modelfile - เรียกใช้โมเดล: ตอนนี้คุณสามารถใช้โมเดลในเครื่องได้ราวกับว่าคุณดาวน์โหลดมาจากไลบรารีมาตรฐานแล้ว
กระบวนการนี้คล้ายคลึงกันมากสำหรับ LM Studio, AnythingLLM และแอปพลิเคชันอื่นๆ ที่เข้ากันได้กับ GGUF
ในทางกลับกัน หากมีเวอร์ชันอย่างเป็นทางการของโมเดลอยู่ในไลบรารีของแพลตฟอร์มของคุณอยู่แล้ว การใช้คำสั่ง "pull" ที่เกี่ยวข้องจะง่ายกว่ามาก แต่การนำเข้าด้วยตนเองเป็นสิ่งสำคัญหากคุณต้องการตัวแปรการหาปริมาณเฉพาะ โมเดลที่ไม่ธรรมดา หรือหากคุณต้องการควบคุมมากขึ้นว่าโมเดลจะถูกจัดเก็บไว้ที่ใดและอย่างไร
แอปพลิเคชันที่เข้ากันได้และการใช้งานจริงหลักของไฟล์ GGUF
ปัจจุบันระบบนิเวศของ GGUFมีขนาดใหญ่มาก ลองดูโครงการหลักและกรณีการใช้งานต่างๆ ได้เลย:
- โอลามา: ช่วยให้คุณสามารถนำเข้าโมเดลจากภายนอก สร้างโมเดลของคุณเอง และทดลองกับการตั้งค่าการควอนไทเซชันและเทมเพลตแบบกำหนดเองได้
- แอลเอ็ม สตูดิโอประกอบด้วยอินเทอร์เฟซกราฟิกที่ใช้งานง่ายมากสำหรับการค้นหา ดาวน์โหลด และติดตั้งโมเดล GGUF รวมถึงการส่งออกไปยังแอปพลิเคชันอื่น หรือเรียกดูผ่าน API ในเครื่อง
- อะไรก็ได้LLM y แจนโซลูชันสำหรับเดสก์ท็อปและองค์กรเพื่อใช้แชทบอท AI ในพื้นที่ พร้อมการสนับสนุนอย่างเต็มรูปแบบสำหรับโมเดล GGUF และเทมเพลตที่ฝึกฝนไว้ล่วงหน้า
- 3DIMLIพจนานุกรมศัพท์เทคนิคและร้านค้าที่นำเสนอโมเดลหรือวัสดุเฉพาะในรูปแบบ GGUF พร้อมคำแนะนำเกี่ยวกับวิธีการบันทึกเวอร์ชันและความเข้ากันได้สำหรับแต่ละกรณีอย่างถูกต้อง
- โครงการโอเพนซอร์สและสภาพแวดล้อมการวิจัย เกิดขึ้นได้ด้วยความสามารถในการทำงานร่วมกันกับ Python และ R
นอกจากนี้ แพลตฟอร์มระดับมืออาชีพและเชิงพาณิชย์หลายแห่งเริ่มนำเสนอเทมเพลตสำเร็จรูปใน GGUF เพื่อเร่งการใช้งานและการบูรณาการโซลูชัน AI ขั้นสูง
ข้อควรระวังและเคล็ดลับในการใช้งานไฟล์ GGUF
- ตรวจสอบความเข้ากันได้เสมอ: ก่อนดาวน์โหลดไฟล์ GGUF ใดๆ โปรดตรวจสอบให้แน่ใจว่าไฟล์นั้นเข้ากันได้กับแอปพลิเคชันของคุณ (เช่น Ollama เวอร์ชันเฉพาะ, LM Studio เป็นต้น) และฮาร์ดแวร์ของคุณ หากรุ่นดังกล่าวต้องการเครื่องยนต์เวอร์ชันเฉพาะ โปรดตรวจสอบหมายเหตุในเว็บไซต์ต้นทาง.
- ตั้งชื่อและจัดระเบียบไฟล์อย่างระมัดระวัง: เนื่องจากบางกระบวนการนั้นคำนึงถึงตัวพิมพ์ใหญ่และตัวพิมพ์เล็ก จึงควรใช้ชื่อที่เรียบง่ายและชัดเจนเพื่อหลีกเลี่ยงข้อผิดพลาดในการโหลด
- ปรับวิธีการวัดผลให้เหมาะสมกับทีมของคุณ: แม้ว่าคุณจะสามารถนำเข้าโมเดล Q8 หรือ Q5 ได้ แต่หาก VRAM ของคุณมีจำกัด ควรเลือกใช้ Q4 หรือ IQ4 จะดีกว่า เพื่อหลีกเลี่ยงปัญหาการล็อกทรัพยากร
- หากคุณสร้างแชทบอท ให้ปรับแต่งเทมเพลต: เมื่อนำเข้าโมเดลแชท อาจจำเป็นต้องปรับเทมเพลตข้อความแจ้งเตือนในไฟล์โมเดลหรือการตั้งค่าเพื่อให้ได้การตอบสนองที่เสถียรและเป็นธรรมชาติมากขึ้น
- โปรดตรวจสอบใบอนุญาตและสิทธิ์ต่างๆ: โมเดล GGUF บางรุ่นมีการกำหนดข้อจำกัดในการใช้งานเพิ่มเติม ตรวจสอบหน้าดาวน์โหลดเพื่อดูว่าคุณสามารถนำไปใช้เพื่อวัตถุประสงค์ทางการค้าหรือเพื่อการแจกจ่ายต่อได้หรือไม่.
คำแนะนำสำหรับการเลือกแบบจำลองและการวัดปริมาณที่เหมาะสม
ดังที่ผู้เชี่ยวชาญและผู้ใช้งานยืนยันแล้ว มีแนวทางปฏิบัติที่ชัดเจนให้ปฏิบัติตาม:
- สำหรับงานประจำวัน (สำหรับการแชท การเขียนโปรแกรม การเขียน การสอบถามทั่วไป): เลือก Q4_K_M เพราะเป็นตัวเลือกที่ลงตัวที่สุดทั้งในด้านคุณภาพและประสิทธิภาพ และรองรับโดยเฟรมเวิร์กเกือบทั้งหมด
- สำหรับงานขั้นสูงหรือคณิตศาสตร์ที่ซับซ้อน: หากคุณมีหน่วยความจำเหลือเฟือ ให้อัปเกรดเป็น Q5_K_M แต่โดยปกติแล้ว ความแตกต่างด้านคุณภาพจะเห็นได้ชัดเจนเฉพาะในงานที่ต้องการประสิทธิภาพสูงเท่านั้น
- ฮาร์ดแวร์ระดับสูงสุด? หากคุณลงทุนซื้อ GPU ขนาดใหญ่และสนใจคุณภาพกราฟิกสูงสุด คุณสามารถลองใช้ Q8_0 ได้ แต่การอัพเกรดจาก Q5 นั้นไม่คุ้มค่าเสมอไป ยกเว้นในกรณีของการทดสอบประสิทธิภาพหรือการวิจัย
- ทรัพยากรมีจำกัด? ลองใช้ IQ4_XS สำหรับการทดสอบ การสร้างต้นแบบอย่างรวดเร็ว หรือเมื่อคุณมี RAM/VRAM เหลือน้อยมาก
- ควรหลีกเลี่ยงไตรมาสที่ 3 และ 2 สำหรับการใช้งานในสภาพแวดล้อมจริงหรือระดับมืออาชีพเนื่องจาก "ขาด" ความสอดคล้องและความแม่นยำของผลลัพธ์
GGUF มีส่วนร่วมอย่างไรในการพัฒนาและอนาคตของ AI ในระดับท้องถิ่นและแบบโอเพนซอร์ส
รูปแบบ GGUF ไม่เพียงแต่เร่งการนำ AI มาใช้ในอุปกรณ์ส่วนบุคคลเท่านั้น แต่ยังทำให้การเข้าถึงโมเดลขั้นสูงเป็นไปอย่างเท่าเทียมกันมากขึ้น ช่วยให้ผู้คนและธุรกิจจำนวนมากขึ้นสามารถ:
- สัมผัสประสบการณ์ความก้าวหน้าล่าสุดในด้านปัญญาประดิษฐ์เชิงสร้างสรรค์ได้ด้วยตนเอง โดยไม่ต้องพึ่งพาบริษัทขนาดใหญ่
- ปรับแต่งโมเดล เพิ่มคุณสมบัติ และแบ่งปันเวอร์ชันที่ปรับแต่งแล้วกับชุมชนหรือกลุ่มวิจัย
- ทดลองใช้สถาปัตยกรรม พารามิเตอร์ และความสามารถในการปรับขนาดที่แตกต่างกัน โดยไม่ต้องกังวลเรื่องความไม่เข้ากันหรือการอุดตัน
GGUF ยังส่งเสริมการพัฒนาเครื่องมือ ตัวแปล และเอนจิ้นใหม่ๆ และรับประกันว่าการพัฒนาในปัจจุบันจะยังคงมีประโยชน์ต่อไปอีกหลายปีด้วยแนวทางที่ขยายได้ ความสามารถในการทำงานร่วมกันและความง่ายในการจัดทำเอกสาร การจัดกลุ่ม และการส่งออก ทำให้ GGUF เป็นรูปแบบมาตรฐานในคลังข้อมูล ร้านค้า พจนานุกรมทางเทคนิค และโครงการชุมชนแบบเปิด
GGUF เผชิญกับความท้าทายและโอกาสอะไรบ้างในอนาคต?
แม้ว่ารูปแบบ GGUF จะเป็นมาตรฐานอยู่แล้ว แต่ชุมชนก็ยังคงถกเถียงและเพิ่มเติมการปรับปรุงต่างๆ อย่างต่อเนื่อง เช่น:
- การเพิ่มประสิทธิภาพสำหรับสถาปัตยกรรมฮาร์ดแวร์ใหม่ (ชิปประมวลผลสำหรับอุปกรณ์พกพา อุปกรณ์ Edge Computing ชิป FPGA เป็นต้น)
- การพัฒนาตัวแปลงข้อมูลระหว่างเฟรมเวิร์กให้ดียิ่งขึ้น เช่น จาก PyTorch หรือ TensorFlow ไปยัง GGUF โดยตรง
- เพิ่มระบบอัตโนมัติในการปรับแต่งเทมเพลตและข้อความแจ้งเตือนสำหรับรูปแบบการสนทนาหรือภารกิจเฉพาะต่างๆ
- การบูรณาการขั้นสูงกับเครื่องมือวัดปริมาณ การปรับปรุงระบบเอกสาร และการค้นพบแบบจำลอง
ทั้งหมดนี้หมายความว่าการดาวน์โหลด การปรับแต่ง และการบูรณาการโมเดล AI ขั้นสูงจะง่ายขึ้น เร็วขึ้น และประหยัดมากขึ้นไม่ว่าจะเป็นสำหรับ SME นักวิจัย ผู้ที่สนใจ หรือแพลตฟอร์มขนาดใหญ่ก็ตาม
รูปแบบ GGUF ได้พิสูจน์แล้วว่าเป็นโซลูชันที่ดีที่สุดสำหรับการใช้งานปัญญาประดิษฐ์แบบควบคุมในระดับท้องถิ่น โดยใช้ทรัพยากรของคอมพิวเตอร์ได้อย่างมีประสิทธิภาพ ไม่ว่าจะเป็นเครื่องที่ทันสมัยหรือเครื่องที่มีสเปคปานกลาง และสามารถผสานรวมโมเดล LLM ล่าสุดในตลาดได้อย่างง่ายดาย ด้วยทรัพยากร บทช่วยสอน และแอปพลิเคชันที่เข้ากันได้มากมาย คุณจึงสามารถค้นหา นำเข้า และเริ่มใช้โมเดลสำเร็จรูปได้ภายในไม่กี่นาที ช่วยเพิ่มประสิทธิภาพทั้งเวลาและค่าใช้จ่าย พร้อมทั้งได้รับความเป็นส่วนตัวและความสามารถในการขยายขนาดสูงสุด GGUF เป็นกุญแจสำคัญสู่ความเปิดกว้าง ความเป็นประชาธิปไตย และอนาคตของปัญญาประดิษฐ์เชิงปฏิบัติ
llama.cpp คืออะไร: คู่มือฉบับสมบูรณ์เกี่ยวกับเทคโนโลยีที่ปฏิวัติวงการ AI ในระดับท้องถิ่น
อาจสนใจ: