Algoritmo de k vecinos más cercanos (kNN): Qué es y cómo funciona en detalle
kNN es un algoritmo de aprendizaje supervisado que predice el resultado de un caso basándose en los k ejemplos más cercanos del conjunto de entrenamiento, siendo clave la elección de k y la métrica de distancia utilizada.
Funciona tanto para clasificación, donde asigna la clase más frecuente entre los vecinos, como para regresión, donde predice usando el valor medio de los vecinos.
Su implementación es sencilla y versátil, pero requiere cuidado en la selección de parámetros y en el preprocesamiento de los datos, especialmente la normalización para evitar sesgos.
¿Alguna vez te has preguntado cómo los ordenadores pueden clasificar objetos o hacer predicciones basándose únicamente en información previa, casi como lo haría una persona con experiencia? El algoritmo de k vecinos más cercanos, mucho más conocido como k-nearest neighbors (kNN), es uno de los métodos más sencillos y efectivos para resolver problemas de clasificación y regresión. Su funcionamiento se inspira directamente en cómo los humanos tomamos decisiones, considerando los ejemplos que tenemos a nuestro alrededor.
Si te interesa el aprendizaje automático (Machine Learning), comprender bien el funcionamiento y las aplicaciones del algoritmo kNN es fundamental. A pesar de su simplicidad, es enormemente útil. Y no te preocupes: en este artículo te explico de forma clara, con todos los detalles importantes y con ejemplos reales para que entiendas de principio a fin qué es, cómo funciona, cuándo se usa y sus ventajas e inconvenientes.
¿Qué es el algoritmo de k vecinos más cercanos (kNN)?
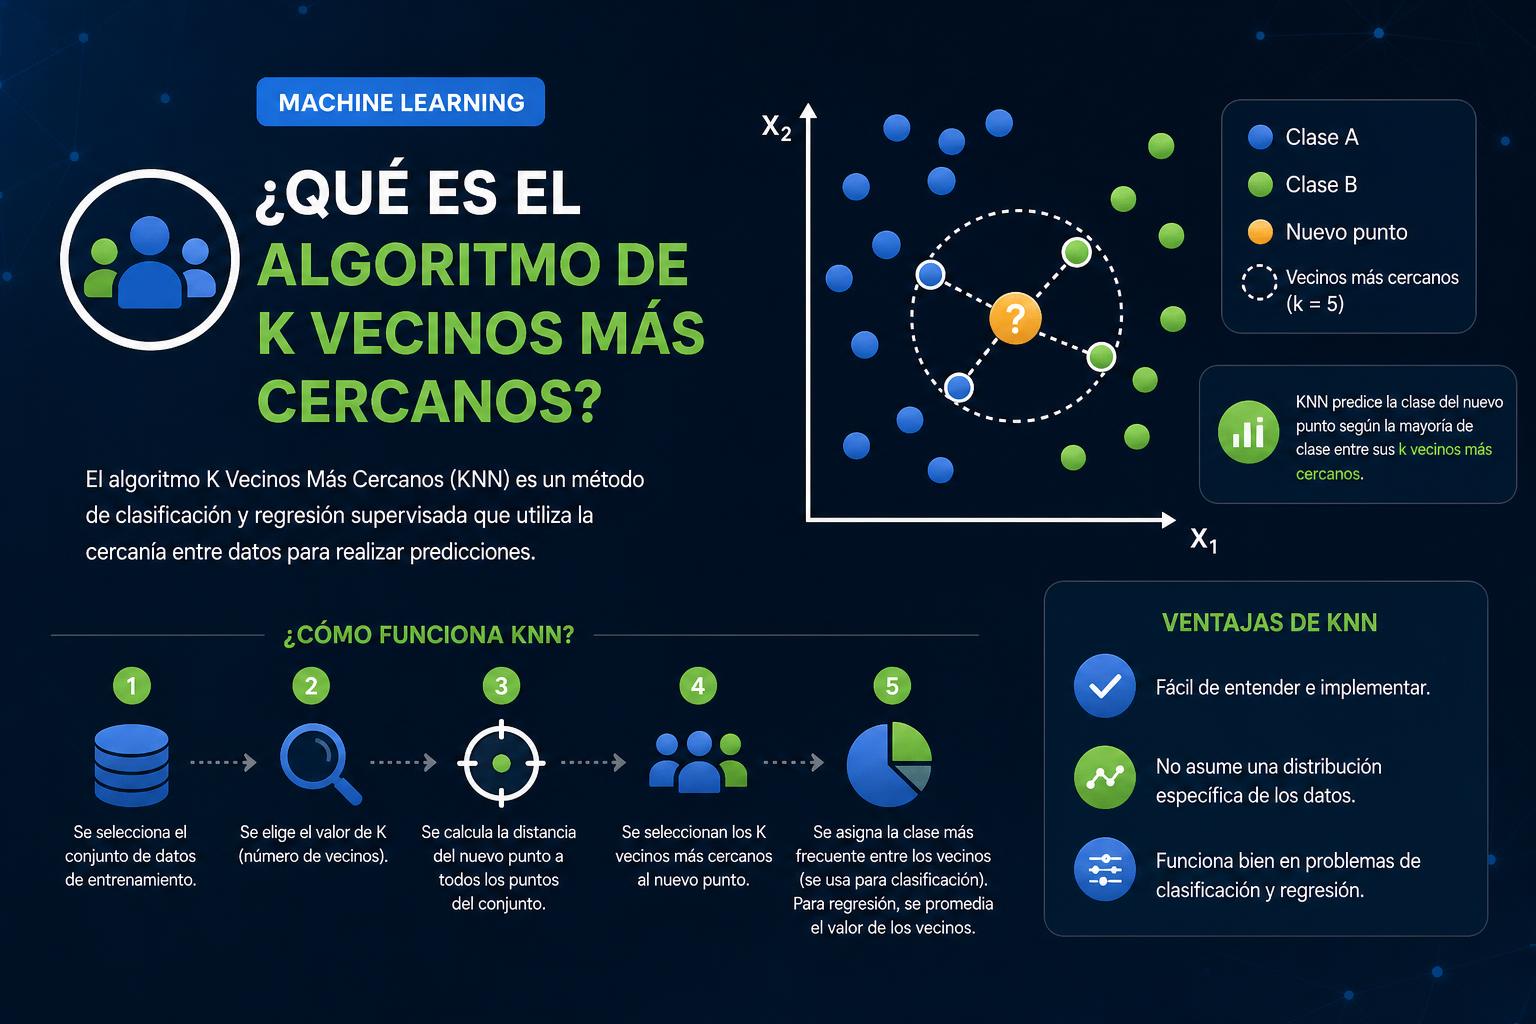
El algoritmo de los k vecinos más cercanos (kNN) es un método de aprendizaje supervisado que permite clasificar y predecir valores tomando como referencia los k ejemplos más similares de un conjunto de datos. En otras palabras, cuando el algoritmo debe realizar una predicción (ya sea de una categoría o de un valor numérico), busca en la base de datos de entrenamiento cuáles son los k ejemplos que más se parecen al nuevo caso y utiliza la información de sus clases o valores para tomar una decisión.
kNN se basa enteramente en la similitud: los datos que están más cerca entre sí suelen comportarse de manera parecida. Este principio tan intuitivo es la base de su éxito. ¿Cómo decide qué es «cerca» o «lejos» un punto de otro? Generalmente se utiliza la distancia euclidiana, aunque hay más formas según el tipo de datos.
¿Por qué se llama k vecinos más cercanos?
La «k» en kNN representa el número de vecinos más próximos que se consideran para hacer la predicción. Si se elige k=3, el algoritmo buscará los 3 ejemplos del conjunto de entrenamiento que estén más cerca del nuevo caso y decidirá la etiqueta o el valor del nuevo caso en función de ellos. Escoger un valor adecuado para k es uno de los temas más relevantes en kNN y más adelante veremos cómo hacerlo.
¿Cómo funciona el algoritmo kNN paso a paso?
La lógica del algoritmo puede resumirse en los siguientes pasos clave:
Elegir el número de vecinos (k). Esta decisión depende del problema concreto y del tamaño de la base de datos.
Calcular la distancia entre el nuevo punto y todos los datos existentes. Generalmente se utiliza la distancia euclidiana, aunque pueden emplearse otras métricas según la naturaleza de los datos.
Seleccionar a los k ejemplos más cercanos al nuevo dato.
Para el caso de clasificación: se cuenta cuántos vecinos pertenecen a cada clase y se asigna la clase más frecuente (votación por mayoría o pluralidad).
Para el caso de regresión: se calcula la media (o a veces la mediana) de los valores de los vecinos y ese será el valor predicho.
Esta mecánica se repite cada vez que queremos clasificar o predecir para un nuevo ejemplo.
El aprendizaje supervisado implica que el algoritmo aprende a partir de datos etiquetados, es decir, todos los ejemplos que le mostramos incluyen ya la respuesta correcta (la clase o el valor). Cuando kNN recibe nuevos datos, compara sus características con los datos que conoce y les asigna la categoría o valor más adecuado en función de los vecinos encontrados. Puedes aprender más sobre aprendizaje supervisado en los recursos completos de liora.io.
¿Para qué sirve el algoritmo de k vecinos más cercanos?
El uso de kNN es muy variado tanto en clasificación como en regresión. En clasificación, el algoritmo dispone de un conjunto de etiquetas posibles (por ejemplo, «spam» o «no spam», «aceptado» o «rechazado», o incluso varias categorías). Para cada nuevo dato, busca los k vecinos más cercanos y les «pregunta» a qué clase pertenecen, asignando por votación mayoritaria la clase con más representantes en esos vecinos (o la más frecuente, si hay más de dos clases). Algunos ejemplos reales:
Reconocimiento de imágenes: ¿es una foto de un gato o de un perro? kNN compara las características de la foto nueva con las de su base de ejemplos.
Predicción de resultados financieros: predecir el precio de una casa o las tendencias del mercado usando precios similares en los alrededores.
Sistemas de recomendación: como sugerir amigos en plataformas sociales, películas o productos que te podrían interesar en función de usuarios con características similares.
Detección de fraudes o intrusiones: el algoritmo puede señalar una transacción anómala si su comportamiento es muy diferente al de la mayoría.
En regresión, el enfoque es muy parecido, pero la salida es un valor numérico continuo y no una etiqueta discreta. Por ejemplo, puedes predecir el peso de una persona en función de la altura, calculando la media del peso de los vecinos más próximos.
Características principales de kNN
Aunque kNN es conocido por su sencillez y fácil implementación, tiene una serie de características que merece la pena destacar:
No necesita una fase de entrenamiento explícita: simplemente memorizando el conjunto de datos de entrenamiento, puede hacer predicciones. Se le considera un algoritmo de aprendizaje perezoso (lazy learner), ya que aprende «en el momento», es decir, ejecuta el cálculo cada vez que hace una predicción.
Dependencia del almacenamiento: como tiene que comparar siempre con todos los ejemplos de entrenamiento, necesita suficiente memoria para almacenar los datos. Esto lo puede hacer lento con conjuntos muy grandes.
No es paramétrico: no crea una función ni modelo intermedio, simplemente basa su decisión en buscar similitudes.
Funciona tanto para clasificación como para regresión. Es muy versátil.
Simplicidad, pero sensible al tamaño y calidad de los datos.
Métricas de distancia en kNN
Calcular las distancias entre puntos es la clave del algoritmo. La más común es la distancia euclidiana, que se calcula como la raíz cuadrada de la suma de las diferencias cuadradas entre las variables de cada observación. Matemáticamente:
La distancia euclidiana es muy intuitiva cuando todas nuestras variables son numéricas y están en la misma escala. Si tienes variables categóricas, puedes utilizar la distancia de Hamming u otras opciones específicas. También es fundamental estandarizar los datos para que ninguna variable «pese» demasiado en el cálculo de distancia. Se recomienda utilizar funciones como scale() en R o Scikit-Learn para normalizar las variables antes de aplicar kNN.
¿Cómo elegir el valor óptimo de k?
Elegir el valor de k adecuado es crítico para el rendimiento del algoritmo. Un valor pequeño de k puede hacer que el algoritmo sea muy sensible al ruido o a valores atípicos (outliers) en los datos, mientras que un valor demasiado grande puede llevar a «suavizar» tanto la frontera entre clases que pierda precisión (el conocido problema de underfitting). La idea es encontrar un equilibrio. Hay varias técnicas y recomendaciones:
Reglas empíricas: Algunos autores sugieren k = sqrt(n), siendo n el número de muestras de entrenamiento. Aunque no es universal, puede servir como punto de partida.
Búsqueda por grillas (grid search): Probar varios valores de k sobre un conjunto de validación y elegir el que proporciona mejor exactitud (accuracy).
Evitar valores pares para k: Para problemas de clasificación binaria es importante usar k impar para evitar empates en la votación.
No escoger k múltiplo del número de clases: Puede llevar a empates ciclicamente. Si hay muchas clases, conviene pensarlo bien.
Máximo valor de k: Una regla práctica es elegir k máximo igual a 2 * min {N, P} + 1, siendo N y P el número de ejemplos en las clases mayoritaria y minoritaria, respectivamente. Así nos aseguramos de no sobrepasar el número de representantes de cualquier clase.
Experimentar y validar el comportamiento del modelo con diferentes valores de k es la mejor estrategia. Esto suele hacerse dividiendo el conjunto de datos en entrenamiento y validación (por ejemplo, 80%-20%) y comparando métricas como accuracy, sensibilidad, especificidad, precisión o F1-score.
Votación por mayoría y pluralidad: matices en clasificación
En problemas de clasificación kNN asigna la categoría al nuevo dato según el resultado de una «votación» entre sus k vecinos más cercanos. Hay dos formas principales de contabilizar los votos:
Votación por mayoría: Se requiere que más del 50% de los vecinos pertenezcan a una clase. Es habitual cuando hay solo dos categorías.
Votación por pluralidad: Se asigna la clase que aparece con más frecuencia entre los vecinos, aunque no llegue al 50%. Este método es más adecuado cuando hay más de dos clases.
Si hay empate, el algoritmo suele elegir la clase al azar. Por ello se prefiere elegir k impar y no múltiplo del número de clases. A la hora de programar el algoritmo, librerías como en Python o facilitan esta configuración.
Implementación práctica de kNN
La sencillez de kNN hace que sea implementable fácilmente en muchos lenguajes de programación y librerías. Algunos puntos importantes a tener en cuenta en la práctica:
Escalar y estandarizar los datos: Fundamental si tus variables están en distintas escalas, así evitas que una variable «domine» el cálculo de la distancia y distorsione los resultados.
Dividir el conjunto de datos: Se recomienda separar un conjunto de entrenamiento y otro de validación/prueba para medir el rendimiento real del modelo y evitar sobreajuste.
Uso de librerías: En Python, es la opción más popular. En R, puedes usar packages como caret, class o dplyr para el preprocesamiento. La función train() de caret permite hacer búsqueda automática del mejor k y ajustar el preprocesamiento.
Recursos online: IBM tiene una completa guía sobre el algoritmo en IBM Knowledge Center, y Elastic también proporciona una explicación integral sobre su funcionamiento y comparación con otros métodos.
Comparativa con otros algoritmos de clasificación
kNN se diferencia de otros métodos como Logit o Naive Bayes en varios aspectos:
Modelo no paramétrico: No calcula parámetros ni asume una función matemática detrás de los datos.
No necesita entrenar un modelo: Todo el trabajo se hace en la fase de predicción (por eso es considerado un «aprendiz rápido» o incluso «perezoso»).
Ventajas frente a modelos paramétricos: Puede adaptarse rápidamente a cambios en los patrones de los datos sin recurrir a re-entrenamientos.
Inconvenientes: Crece la demanda de memoria y de tiempo cuando hay muchos datos o cuando las variables son muy numerosas.
Estudios con bases de datos reales demuestran que kNN puede superar a otros algoritmos en métricas como la exactitud (accuracy), aunque a veces sea menos sensible (capacidad de detectar todos los positivos).
Ejemplo práctico: Predicción con kNN en R
Supón que tienes una base de datos sobre campañas de marketing bancario (puedes encontrar datasets comerciales en y Universidad Icesi), y quieres predecir si un cliente va a contratar un producto financiero.
Estandariza las variables numéricas para que la distancia entre puntos sea significativa.
Divide los datos en muestra de entrenamiento (por ejemplo, 80%) y validación (20%).
Selecciona k mediante búsqueda por grilla y comparación de métricas.
Implementa kNN usando una librería como caret en R:
Observa las métricas del modelo: accuracy, precisión, especificidad, sensibilidad, F1, etc.
El proceso de ajuste te permitirá identificar el valor óptimo de k, y observar cómo varía el rendimiento en función del mismo.
Ventajas y desventajas de kNN
Ventajas:
Método simple y fácil de interpretar. Resulta ideal como primer paso en muchos problemas.
No necesita supuestos previos sobre la distribución de los datos.
Muy versátil. Funciona para clasificación y regresión, y se adapta bien a distintas áreas.
Adaptable a nuevos datos. Puedes añadir ejemplos fácilmente sin re-entrenar un modelo.
Desventajas:
Escalabilidad limitada. Cuantos más datos y más variables, mayor consumo de memoria y menor rapidez.
Sensibilidad al valor de k. Hay que experimentar o validar bien cuál es el óptimo para el problema específico.
Problemas con datos no numéricos. Necesita transformaciones o distancias adaptadas para variables categóricas.
Propenso a resultados pobres si los datos están desbalanceados o contienen mucho «ruido».
Ejemplos de aplicaciones reales de kNN
El kNN es la base de muchos sistemas utilizados en la vida cotidiana, como reconocimiento de escritura y OCR, referencia en OpenCV para tareas de visión por computadora.
Reconocimiento de escritura y OCR: Detectar letras manuscritas o distinguir caracteres en imágenes utilizando similitud con ejemplos previos.
Sistemas de scoring de crédito: Clasificar la solvencia de un individuo a partir del historial de otros con perfil similar. Si las características coinciden con personas solventes, el algoritmo lo considera también de bajo riesgo.
Préstamos bancarios: Predecir si un banco debe o no conceder un préstamo a alguien, comparando su perfil con ejemplos de otros clientes que obtuvieron o no el crédito.
Minería de datos y análisis de mercado: Detección de patrones de compra y predicción de tendencias según la similitud con otros clientes.
Detección de intrusiones en ciberseguridad: Señalar eventos sospechosos comparando características del tráfico con ejemplos históricos.
Diferencias frente a otros métodos de agrupamiento
Es importante distinguir kNN de otros algoritmos relacionados, como k-means para clustering (agrupamiento no supervisado). Mientras kNN busca vecinos más próximos para un punto dado utilizando datos etiquetados, k-means busca dividir los datos en grupos (clusters) homogéneos sin conocer las etiquetas. Otros algoritmos útiles para clustering incluyen DBSCAN o el CAH (Clasificación ascendente jerárquica).
Evaluación del rendimiento de un modelo kNN
Elegir k y configurar adecudamente el cálculo de distancias no es suficiente; hay que medir cómo de bien está funcionando el algoritmo.
Matriz de confusión: Analiza los aciertos y errores de cada clase.
Exactitud (accuracy): Porcentaje de ejemplos correctamente clasificados sobre el total.
Sensibilidad (recall): Capacidad de detectar los verdaderos positivos.
Especificidad: Capacidad de identificar correctamente los negativos.
Precisión: Proporción de positivos predichos que realmente son positivos.
F1-score: Media armónica entre precisión y sensibilidad.
En aplicaciones reales se suelen comparar varias métricas, ya que priorizar una sobre otra puede ser crítico dependiendo del objetivo (por ejemplo, evitar falsos negativos en diagnósticos médicos).
Consejos prácticos para sacar el máximo partido a kNN
Preprocesa siempre tus datos. La calidad y la limpieza de los datos influyen mucho más que en otros modelos.
Estandariza variables para evitar resultados sesgados.
Evalúa el rendimiento con varias métricas, especialmente si hay clases desbalanceadas.
Si tienes mucho volumen de datos, considera técnicas de optimización como KD-trees o Ball-trees para acelerar la búsqueda de vecinos.
Referencias y recursos recomendados para aprender más
El algoritmo de k vecinos más cercanos se ha convertido en una herramienta fundamental en el aprendizaje automático debido a su sencillez conceptual y su efectividad dentro de toda clase de industrias. Aunque tiende a quedarse corto en aplicaciones con cientos de miles o millones de observaciones por sus requerimientos de memoria y velocidad, es perfecto para análisis exploratorio, para comprender la estructura de los datos y como punto de partida en la construcción de modelos predictivos más sofisticados. Su versatilidad, facilidad de uso y la posibilidad de adaptarlo a muy distintas tareas lo mantienen plenamente vigente en la ciencia de datos. Si buscas una manera simple y potente de iniciar en Machine Learning, kNN es tu gran aliado para experimentar, aprender y descubrir patrones ocultos en tus propios datos.