Formato GGUF: Qué es, cómo funciona y cómo aprovecharlo para modelos de IA
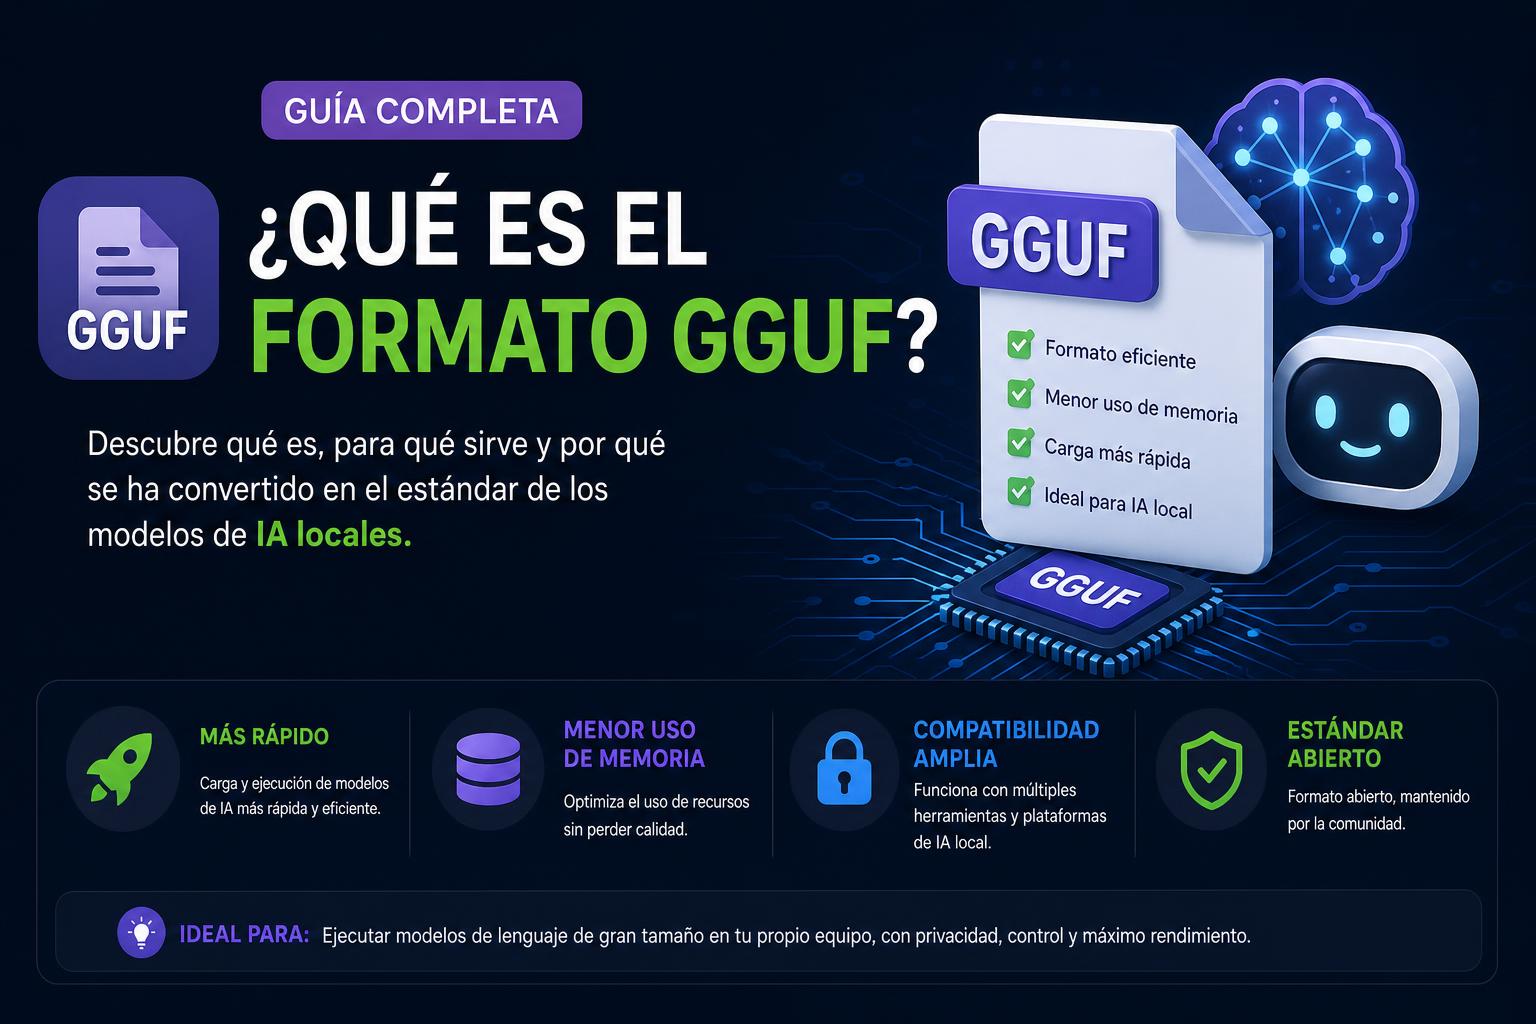
GGUF es el formato de referencia para compartir y ejecutar modelos de IA locales, superando en flexibilidad y compatibilidad a formatos previos.
Sus diferentes niveles de cuantización permiten adaptar el rendimiento y el consumo de recursos al hardware de cada usuario, desde equipos modestos hasta estaciones potentes.
Descargar e importar modelos GGUF en aplicaciones como Ollama, LM Studio o AnythingLLM es sencillo y permite desarrollar soluciones de IA personalizadas incluso sin conexión a Internet.
La gran comunidad alrededor de GGUF, con repositorios como Hugging Face, facilita encontrar versiones actualizadas, recursos y soporte para diversos casos de uso.
¿Has oído hablar últimamente de los archivos GGUF y te preguntas qué son y para qué sirven? El mundo de la inteligencia artificial avanza a pasos de gigante y los formatos de archivo juegan un papel crucial a la hora de ejecutar modelos potentes, tanto para profesionales como para entusiastas que quieren sacar el máximo partido a sus equipos locales.
En este extenso artículo vamos a descubrir en profundidad todo lo relacionado con el formato GGUF: en qué consiste, para qué se creó, cómo ha revolucionado el uso de grandes modelos de lenguaje (LLM), sus ventajas frente a formatos anteriores, los niveles de cuantización, dónde descargar modelos y cómo integrarlos en distintas plataformas y aplicaciones de IA.
El formato GGUF (GGML Universal Format) es un archivo binario diseñado específicamente para almacenar, guardar y cargar rápida y eficientemente modelos de inteligencia artificial de gran tamaño, principalmente LLM (Modelos de Lenguaje como GPT, Llama, Gemma, Grok, entre otros) y modelos RAG (Retrieval Augmented Generation). GGUF surge tras la experiencia previa con GGML, adaptándose a las necesidades actuales de desarrolladores, empresas y comunidad: compatibilidad, eficiencia, flexibilidad y facilidad de integración en diferentes plataformas y aplicaciones.
GGUF ha sido desarrollado como el sucesor natural del formato GGML, aportando notables mejoras que responden a la creciente demanda de hardware menos especializado, garantizando que los grandes modelos de IA puedan ser utilizados no solo en potentes servidores o nubes, sino incluso en ordenadores de sobremesa, portátiles e incluso algunos dispositivos móviles con recursos limitados.
Diferencias y ventajas respecto a GGML y otros formatos
Si bien GGML ya supuso un gran avance frente a modelos tradicionales, GGUF eleva aún más el listón en varios aspectos clave. Veamos las diferencias y mejoras principales:
Extensibilidad y futuro asegurado: GGUF está pensado para incorporar nuevas funcionalidades, opciones de metadatos o parámetros que puedan requerir futuros modelos, sin perder compatibilidad hacia atrás. Esto facilita que tanto nuevos desarrollos como herramientas existentes puedan beneficiarse de mejoras sin tener que rehacer todo desde cero.
Flexibilidad en la estructura: Permite organizar los datos del modelo de modo más eficiente, adaptándose a distintas arquitecturas y frameworks, especialmente para modelos de IA emergentes o experimentales.
Interoperabilidad y compatibilidad: GGUF se ha diseñado para poder ser usado sin problemas en una amplísima gama de entornos: desde aplicaciones de Python o R hasta motores como llama.cpp, Ollama, AnythingLLM o LM Studio. Esto hace que los usuarios puedan compartir, descargar e importar modelos sin preocuparse por incompatibilidades o cambios en los flujos de trabajo.
Tamaño optimizado y rapidez de carga: Gracias a diversos niveles de compresión y cuantización, los archivos GGUF logran que los modelos sean mucho más ligeros y rápidos de cargar, ahorrando memoria y acelerando la inferencia (respuesta del modelo en tiempo real).
Soporte activo y comunidad: Al ser un estándar abierto y en constante evolución, hay una gran comunidad participando tanto en el desarrollo del formato como en la creación y testeo de nuevas versiones de modelos optimizadas y documentadas.
¿Para qué sirve GGUF y qué te permite hacer?
El formato GGUF sirve principalmente para almacenar modelos de IA en un formato compacto, portátil y muy eficiente, preparado específicamente para su ejecución local. De esta forma, puedes descargar modelos de última generación entrenados previamente (como GPT, Gemma, Llama, Grok, Mistral, etc.) y ejecutarlos en tu propio ordenador, sin depender de servicios en la nube, sin enviar datos personales a otras compañías y con respuestas en tiempo real adaptadas a tus necesidades.
Esta capacidad resulta especialmente útil para:
Desarrolladores de aplicaciones de chatbots IA, asistentes personales, motores de búsqueda inteligentes o tareas de análisis y procesamiento de texto avanzado.
Profesionales que requieren privacidad absoluta en sus procesos de IA, dada la naturaleza local de los modelos GGUF.
Personas que quieren optimizar costes y recursos, evitando el pago recurrente por APIs externas o servicios online.
Empresas y particulares interesados en experimentar, hacer fine-tuning (ajuste fino personalizado) o trabajar con modelos IA de forma offline.
Entornos educativos y de investigación donde compartir modelos y ajustes entre usuarios de distintas plataformas es prioritario.
¿De dónde ha salido GGUF y cómo se diferencia de formatos como PyTorch, Safetensors, GPTQ, etc.?
La familia de formatos para modelos de IA es muy variada, pero cada uno responde a necesidades y limitaciones distintas:
PyTorch (.pth, .pt, binarios, safetensors…): Se usan habitualmente durante el entrenamiento o durante el fine tuning en entornos de desarrollo, y suelen requerir hardware potente solo para GPU. Además, incluyen gran cantidad de metadatos y código, lo que aumenta su tamaño y complejidad.
GGML: Nació como respuesta para facilitar la inferencia local, pero ha sido rápidamente superado por GGUF gracias a las mejoras ya mencionadas.
GGUF: Nace para cubrir la portabilidad, compatibilidad y la posibilidad de fácil actualización junto con esquemas de cuantización modernos.
GPTQ, AWQ, EXL2, QLoRA, LoRA…: Son métodos de cuantización y ajuste fino que permiten reducir drásticamente el peso (tamaño) del modelo, ajustando la precisión y aprovechando recursos como GPUs o CPUs de forma óptima. Muchos modelos GGUF están cuantizados bajo estos métodos.
En resumen, que es el Formato GGUF es el formato pensado no solo para la inferencia local, sino también para compartir modelos listos para su uso en una gran variedad de herramientas y plataformas, independientemente del sistema operativo o la arquitectura.
Cuantización en GGUF: ¿Qué significa y cómo afecta al modelo?
Desde el auge de los modelos LLM, el concepto de cuantización se ha vuelto clave: consiste en reducir la precisión (bits) de los “pesos” o parámetros internos del modelo IA durante el guardado o exportación, cambiando, por ejemplo, de formatos de 16 bits (FP16) o incluso 32 bits a representaciones mucho más ligeras de 8, 5, 4 o incluso 2 bits. Esto significa que el modelo ocupa mucho menos espacio, necesita menos memoria RAM y calcula mucho más rápido, a cambio de una ligera pérdida de precisión en las respuestas.
El formato GGUF lleva esta flexibilidad extrema a su máxima expresión: incluye “cuantizaciones” de varios niveles y es compatible tanto con enfoques tradicionales (para alcanzar máxima calidad) como con niveles ultra comprimidos ajustados a hardware limitado.
Principales esquemas de cuantización en GGUF
Q4_K_M (o variantes Q4…): El equilibrio ideal para la mayoría de usuarios: ocupa poco, resulta rápido y la calidad es casi idéntica al modelo original en tareas cotidianas (Q&A, programación, redacción, resúmenes, etc.). Suele ser el valor por defecto recomendado.
Q5_K_M: Recomendado cuando buscas mejor calidad y tu hardware dispone de suficiente VRAM (memoria gráfica). Notarás mejores resultados en tareas de razonamiento complejo, matemáticas avanzadas y contextos exigentes.
Q8_0: La representación con máxima calidad compatible (casi igual a los originales sin comprimir). Solo recomendable si puedes asumir el gran tamaño de archivo y tienes mucha memoria RAM/VRAM.
IQ4_XS: El formato más pequeño y ligero que aún resulta utilizable. Perfecto para pruebas, experimentación rápida o dispositivos con muy poca VRAM.
Evita Q3 y Q2 si buscas calidad: La pérdida de precisión suele ser muy notable y solo resultan útiles en entornos muy restringidos o para tareas concretas.
Niveles de cuantización: comparación y casos de uso
¿Qué nivel elegir? Aquí es donde el formato GGUF brilla por su versatilidad. Según las necesidades, puedes elegir:
Cuantización de 2 bits: Tamaño mínimo, máxima compresión. Usado en dispositivos muy limitados, pero la pérdida de calidad puede ser elevada.
Cuantización de 4 bits: Compresión y velocidad muy superiores sin perder apenas calidad para tareas comunes. Solución preferida para muchos desarrolladores.
Cuantización de 8 bits: Casi la máxima fidelidad y apenas compresión comparada con los originales sin procesar.
Al combinar esto con los distintos métodos (GPTQ, AWQ, QLoRA, etc.), GGUF permite desplegar el mismo modelo con diferentes “sabores”, adaptándose a cada caso de uso y hardware disponible.
¿Qué ventajas prácticas ofrece GGUF a usuarios y empresas?
Carga ultrarrápida: Gracias a su formato binario y estructura eficiente, es posible cargar modelos en segundos, importante para aplicaciones y servicios sensibles al tiempo o con actualización frecuente.
Portabilidad y estandarización: Compartir, copiar e instalar modelos GGUF es tan fácil como mover un único archivo, sin líos de dependencias ni versiones.
Compatibilidad: Se integra con una enorme variedad de frameworks (Python, R, CUDA, etc.) y aplicaciones (desde Ollama hasta AnythingLLM, LM Studio, o chatbots personalizados).
Consumo energético reducido: Los modelos cuantizados de GGUF, al necesitar menos recursos, ayudan a reducir la factura eléctrica y la huella de carbono del hardware, facilitando además su uso en dispositivos edge o soluciones móviles.
Actualización y escalabilidad: Incorporar nuevos tipos de datos o parámetros es trivial, por lo que GGUF está preparado para los futuros avances del sector IA.
¿Dónde descargar archivos GGUF y cómo integrarlos en tus proyectos?
La fuente principal y más famosa de modelos GGUF es la sección de Archivos GGUF en Hugging Face. Allí puedes filtrar, buscar y descargar gratuitamente miles de modelos LLM y variantes RAG cuantizados en diferentes niveles, ya listos para usar en local.
Además de Hugging Face, algunas aplicaciones permiten descargar modelos desde sus propias interfaces o incluso transferirlos y gestionarlos desde directorios locales, exportando o importando a otras apps (como LM Studio, AnythingLLM o Chatbox).
Cómo importar un archivo GGUF descargado a Ollama
Descarga el modelo GGUF: Elige el nivel de cuantización que mejor se adapte a tu hardware y guárdalo en una carpeta local.
Crea un archivo Modelfile: En el mismo directorio, crea un archivo (por ejemplo, “Modelfile”) con una línea FROM apuntando al nombre real de tu archivo .gguf. Esto le indica a Ollama de dónde debe cargar el modelo.
Carga el modelo en Ollama: Ejecuta el comando adecuado para importar el modelo usando la opción “-f Modelfile”. Ejemplo: ollama create myModelName -f Modelfile
Ejecuta el modelo: Ya puedes hacer uso del modelo local como si lo hubieras descargado desde la librería estándar.
Este proceso es muy similar para LM Studio, AnythingLLM y otras aplicaciones compatibles con GGUF.
Por otra parte, si ya existen versiones oficiales del modelo en la biblioteca de tu plataforma, es aún más sencillo utilizar el comando “pull” correspondiente, pero la importación manual es clave si necesitas una variante específica de cuantización, un modelo poco habitual o si prefieres mayor control sobre dónde y cómo se almacena el modelo.
Aplicaciones compatibles y principales usos reales de los archivos GGUF
Actualmente, el ecosistema GGUF es amplísimo. Echa un vistazo a los principales proyectos y contextos de uso:
Ollama: Permite importar modelos externos, crear los tuyos propios y experimentar con ajustes de cuantización y templates personalizados.
LM Studio: Incluye una interfaz gráfica muy sencilla para buscar, descargar e instalar modelos GGUF, además de exportarlos a otras apps o consultarlos vía API local.
AnythingLLM y Jan: Soluciones de escritorio y empresariales para usar chatbots IA locales, con soporte total para modelos GGUF y plantillas pre-entrenadas.
3DIMLI: Glosarios técnicos y tiendas que ofrecen modelos o materiales específicos en GGUF, con recomendaciones sobre cómo documentar correctamente versiones y compatibilidades para cada caso.
Proyectos open source y entornos de investigación, gracias a la interoperabilidad con Python y R.
Además, varias plataformas profesionales y comerciales empiezan a ofrecer modelos listos en GGUF para acelerar el deployment e integración de soluciones avanzadas de IA.
Cuidados y consejos prácticos al trabajar con archivos GGUF
Verifica siempre la compatibilidad: Antes de descargar cualquier archivo GGUF, revisa que sea compatible con tu aplicación (versión concreta de Ollama, LM Studio, etc.) y tu hardware. Si el modelo requiere una versión de motor concreta, verifica esa nota en la web de origen.
Nombra y organiza cuidadosamente los archivos: Dado que algunos procesos diferencian entre mayúsculas, minúsculas o incluso espacios, usa nombres simples y claros para evitar errores en la carga.
Adecúa la cuantización a tu equipo: Aunque puedas importar modelos Q8 o Q5, si tu VRAM es limitada es mejor optar por Q4 o IQ4, y así evitar bloqueos por falta de recursos.
Personaliza plantillas si creas chatbots: Al importar modelos de chat, puede ser necesario ajustar la plantilla (prompt template) en el Modelfile o configuración para lograr respuestas más estables y naturales.
Atención a licencias y derechos: Algunos modelos GGUF añaden restricciones de uso. Consulta la página de descarga para comprobar si puedes usarlos con fines comerciales o para redistribución.
Recomendaciones para elegir el modelo y la cuantización idónea
Tal y como han comprobado expertos y usuarios, hay una clara guía práctica a seguir:
Para tareas del día a día (chatear, programar, redacción, consultas generales): elige Q4_K_M. Es el auténtico “punto dulce” en calidad/rendimiento y está soportado por casi todos los frameworks.
Para trabajo avanzado o matemáticas complejas: Si tienes suficiente memoria, sube a Q5_K_M, pero normalmente la diferencia en calidad solo será notoria en tareas exigentes.
¿Hardware top? Si has invertido en una GPU grande y te interesa la máxima fidelidad, puedes probar Q8_0, pero el salto frente a Q5 no siempre se justifica salvo en benchmarking o investigación.
¿Recursos limitados? Prueba IQ4_XS para pruebas, prototipos rápidos o cuando vayas ajustadísimo de RAM/VRAM.
Evita Q3/Q2 para entornos reales o profesionales, ya que “sufre” en coherencia y precisión de resultados.
Cómo contribuye GGUF al desarrollo y futuro de la IA local y open source
El formato GGUF no solo acelera la adopción de IA en dispositivos personales, sino que democratiza el acceso a modelos avanzados. Permite a más personas y empresas:
Probar de primera mano los últimos avances en IA generativa sin tener que depender de grandes corporaciones
Personalizar modelos, añadir funciones y compartir versiones ajustadas a comunidades o grupos de investigación
Experimentar con diferentes arquitecturas, parámetros y escalabilidad sin miedo a incompatibilidades o bloqueos
GGUF fomenta además la aparición de nuevas herramientas, traductores y motores, y garantiza que los desarrollos actuales seguirán siendo útiles años después gracias a su enfoque extensible. La interoperabilidad y la facilidad para documentarlo, agruparlo y exportarlo hace que sea un formato de referencia, tanto en repositorios como como en tiendas, glosarios técnicos y proyectos abiertos de la comunidad.
¿Qué retos y oportunidades hay para el futuro de GGUF?
Si bien el formato GGUF ya es una referencia, la comunidad sigue debatiendo y añadiendo mejoras como:
Desarrollo de mejores conversores entre frameworks, por ejemplo desde PyTorch o TensorFlow directamente a GGUF
Mayor automatización en el ajuste de plantillas y prompts para modelos de chat o tareas específicas
Integración avanzada con herramientas de cuantización, mejoras en los sistemas de documentación y descubrimiento de modelos
Todo esto supondrá que descargar, personalizar e integrar modelos de IA avanzados será cada vez más fácil, rápido y asequible, tanto para pymes, investigadores, entusiastas o grandes plataformas.
El formato GGUF se ha consolidado como la mejor solución para ejecutar inteligencia artificial local y controlada, aprovechando muy bien los recursos de tu ordenador, ya sea de última generación o más modesto, e integrando de manera sencilla los últimos modelos LLM del mercado. Con la cantidad de recursos, tutoriales y aplicaciones compatibles que existen, es cuestión de minutos encontrar, importar y empezar a usar modelos listos, optimizando tanto tiempo como costes y disfrutando de la máxima privacidad y escalabilidad. GGUF es clave en la apertura, democratización y futuro de la inteligencia artificial práctica.