Inicio » Software » Qué es una base de datos vectorial: guía completa y ejemplos prácticos
Qué es una base de datos vectorial: guía completa y ejemplos prácticos
Las bases de datos vectoriales permiten búsquedas semánticas más allá de palabras clave exactas.
Ofrecen integración avanzada entre vectores y metadatos para búsquedas híbridas y filtros precisos.
Son esenciales para IA generativa, buscadores inteligentes y aplicaciones con datos no estructurados.
Las bases de datos vectoriales están revolucionando la gestión y búsqueda de datos en la era de la inteligencia artificial (IA) y el aprendizaje automático. Donde antes los datos se organizaban en estructuras tradicionales, hoy la demanda de soluciones para datos no estructurados, como imágenes, audio, texto largo o vídeos, marca la pauta tecnológica. Comprender qué es una base de datos vectorial y cómo funciona es fundamental para cualquier persona interesada en las nuevas arquitecturas de datos, el desarrollo de aplicaciones avanzadas y la explotación inteligente de la información en contextos cada vez más complejos.
Si alguna vez te has preguntado cómo hacen los motores de recomendaciones, asistentes virtuales o buscadores para encontrar información relevante aun cuando las palabras no coinciden exactamente, la respuesta suele estar en las bases de datos vectoriales. Su capacidad para procesar grandes volúmenes de datos no estructurados, entender el significado y la similitud semántica, y combinar filtros específicos es lo que permite desde búsquedas de imágenes por contenido hasta la mejora de chatbots apoyados por IA generativa. Vamos a profundizar en este concepto y todo lo que ofrecen las bases de datos vectoriales, integrando lo último de IBM, AWS, Google Cloud, Elastic y los líderes del sector.
¿Qué es una base de datos vectorial? Conceptos clave
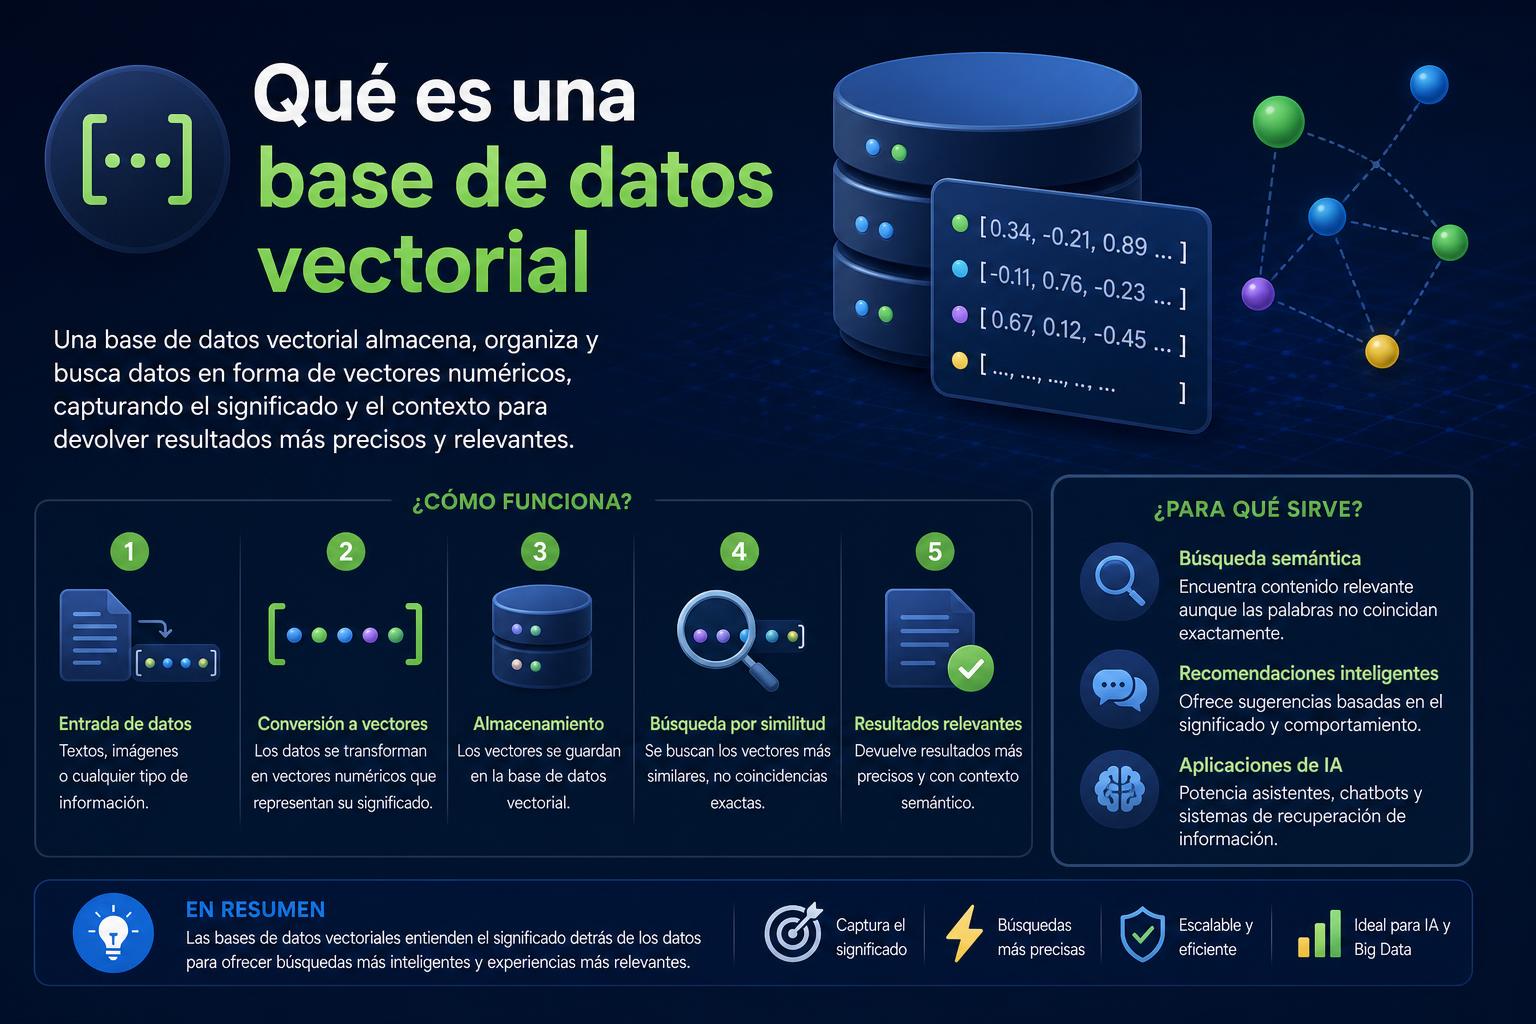
Una base de datos vectorial es un sistema especializado para almacenar, gestionar e indexar datos que han sido trasformados en vectores de alta dimensión a través de técnicas de aprendizaje automático, conocidas como embeddings. En lugar de organizar la información en filas, columnas y tablas como haría una base de datos relacional clásica, los datos se convierten en puntos de un espacio vectorial, donde cada dimensión del vector representa una característica aprendida a partir de los datos originales.
Esto significa que la relación entre los datos se mide a partir de la proximidad o distancia entre sus vectores asociados en ese espacio matemático. Gracias a este enfoque geométrico, no solo pueden encontrarse coincidencias exactas sino también relaciones semánticas profundas; por ejemplo, una búsqueda de «perro» podría arrojar resultados relacionados como «can», «mascota» o incluso razas específicas, aunque estos términos no hayan sido mencionados textualmente.
El cambio en la naturaleza de los datos
La explosión de datos no estructurados ha motivado el desarrollo de las bases de datos vectoriales. Publicaciones en redes sociales, imágenes, clips de audio o grabaciones de vídeo constituyen la mayor parte de la información generada hoy en día, y resultan prácticamente imposibles de gestionar mediante las estructuras rígidas de las bases de datos relacionales tradicionales.
Mientras que las bases de datos relacionales son ideales para grandes volúmenes de información estructurada -por ejemplo, registros financieros, inventarios de productos, datos de clientes-, su uso para datos no estructurados requiere trabajos adicionales de transformación, anotación manual y preparación que elevan tanto la complejidad como el coste.
¿Por qué las bases de datos vectoriales son diferentes?
La principal diferencia de las bases de datos vectoriales radica en cómo representan y consultan la información. Aquí, cada elemento almacenado -sea texto, imagen, vídeo, audio-, primero pasa por un proceso de embedding realizado por un modelo de IA o aprendizaje automático, que lo traduce a un vector de alta dimensión. Estos vectores capturan las características esenciales y latentes, permitiendo que la base de datos mida la similitud entre ellos mediante distancias geométricas.
Las búsquedas dejan de ser simples coincidencias por palabra clave: Se puede encontrar información aunque no exista ninguna palabra coincidente exacta, ya que la comparación se basa en el significado subyacente.
Capacidades de búsquedas semánticas y mejoras drásticas en la relevancia de los resultados: Ideal para aplicaciones que requieren entender contexto y significado, como buscadores inteligentes o sistemas de recomendaciones.
Funcionamiento general de una base de datos vectorial
El proceso comienza por la generación de vectores a partir del contenido original. Estos vectores se conocen como embeddings. Los modelos generativos (como los basados en IA, incluidos los de texto, imagen, etc.) extraen patrones y características fundamentales del contenido y los convierten en valores numéricos dentro de un vector. Este vector se almacena en la base de datos vectorial junto con posibles metadatos (fecha, fuente, etiquetas, etc.).
Al consultar la base de datos, se genera un vector de consulta a partir del término o contenido de búsqueda, y el sistema responde con los vectores más cercanos según la métrica de similitud definida (como la distancia euclidiana, coseno, etc.). Este mecanismo es lo que permite encontrar contenidos afines aunque no se empleen las mismas expresiones ni etiquetas.
Caso práctico: búsquedas híbridas y filtrado avanzado
La combinación de búsqueda vectorial y por metadatos da lugar a las búsquedas híbridas, una de las tendencias más importantes en este campo. Por ejemplo, imaginemos una aplicación inmobiliaria donde el usuario describe el estilo de vivienda que busca con términos como «modernidad, grandes ventanales y luz natural», y a la vez exige parámetros concretos como presupuesto, número de habitaciones o ubicación geográfica.
Con una base de datos vectorial compatible con búsquedas híbridas, como AlloyDB de Google Cloud, es posible realizar ambas restricciones simultáneamente: el índice de búsqueda vectorial identifica las viviendas más parecidas en estilo y el motor SQL filtra las opciones que cumplen los criterios duros (precio, cantidad de dormitorios, localización).
Esto optimiza drásticamente el rendimiento, ya que se evita filtrar resultados inútiles a posteriori. La base de datos lo hace en una sola pasada, respondiendo en milisegundos.
Ventajas principales de las bases de datos vectoriales
Alta capacidad para búsquedas semánticas en grandes volúmenes de datos no estructurados: Gracias a los embeddings, es posible medir similitud más allá de las palabras exactas, permitiendo descubrir información relevante aunque el lenguaje varíe.
Escalabilidad y baja latencia: Diseñadas para responder consultas complejas incluso en contextos donde hay millones de registros vectoriales.
Operativización de modelos de IA y aprendizaje automático en aplicaciones reales: Facilitando la gestión y consulta eficiente de embeddings generados por estos modelos.
Mejora la experiencia de usuario en buscadores y asistentes virtuales: Al permitir búsquedas más inteligentes e intuitivas.
Perfectas para sistemas de recomendación, clasificación automática y categorización dinámica.
Aplicaciones más frecuentes de las bases de datos vectoriales
El auge de las bases de datos vectoriales se debe a la amplia gama de aplicaciones interesantes y útiles en la vida real:
Buscadores semánticos y motores de búsqueda inteligente: Permiten a los usuarios encontrar contenido relacionado aunque utilicen expresiones diferentes.
Recomendadores de productos, música, películas o artículos: Basados en similitud de preferencias según los embeddings de los objetos y del usuario.
Clasificación y agrupamiento automático de grandes volúmenes de documentos, imágenes o fragmentos audiovisuales.
Integración con chatbots y asistentes basados en IA generativa: Para acelerar la recuperación de información desde embeddings y dotar a los sistemas conversacionales de contextos precisos que eviten las denominadas «alucinaciones» (errores o respuestas inventadas por los modelos generativos).
Integración de metadatos y búsqueda híbrida
Las bases de datos vectoriales modernas permiten combinar los vectores con metadatos tradicionales, como etiquetas, fechas, ubicaciones, etc., abriendo la puerta a la búsqueda híbrida. Esto significa que una consulta puede aprovechar tanto el filtrado clásico basado en atributos específicos del contenido como la búsqueda avanzada mediante similitud vectorial.
AWS, por ejemplo, en su guía para desarrolladores, señala que es posible fusionar metadatos extraídos automáticamente (como etiquetas, entidades reconocidas, fechas o autores) y usarlos junto al vector correspondiente. Esto potencia búsquedas mucho más ricas y precisas, en donde la relevancia puede provenir tanto de filtros objetivos como del significado global del contenido.
Despliegue y seguridad: dónde y cómo se usan las bases de datos vectoriales
El lugar donde se ejecuta una base de datos vectorial va cobrando cada vez más importancia en función de la sensibilidad y el tipo de datos que maneja la organización. La mayoría de soluciones están disponibles bajo servicios gestionados en la nube, como en Google Cloud o AWS, pero muchas organizaciones requieren desplegarlas en infraestructuras propias, bien sea localmente (on-premise) o en entornos totalmente aislados, por razones de privacidad y cumplimiento normativo.
Según la información proporcionada por Elastic, el despliegue local garantiza que los datos nunca salgan del perímetro de la red de una organización, facilitando el control total sobre instalación, escalado, actualizaciones y seguridad. En entornos aislados, incluso se evita cualquier conexión al exterior, incrementando la seguridad en sectores críticos o altamente regulados (defensa, banca, sanidad, etc.).
En contextos como agencias gubernamentales y de defensa, a menudo se exigen acreditaciones y controles estrictos antes de desplegar cualquier sistema, descartando el uso exclusivo en cloud público.
Proveedores de atención médica o entidades financieras pueden exigir residencia de datos en ubicaciones físicas o jurídicas específicas, por lo que precisan bases de datos vectoriales que funcionen tanto en local como en la nube.
La elección de un sistema que soporte todos los modos de despliegue (cloud gestionada o autogestionada, local, aislada) facilita la estandarización tecnológica y la gestión regulatoria.
Retos y limitaciones en bases de datos vectoriales modernas
Si bien el potencial de las bases de datos vectoriales es enorme, también presentan desafíos particulares:
Necesidad de modelos de embeddings bien entrenados y representativos: La calidad de los resultados depende de la habilidad de los modelos IA para traducir el significado de los datos a vectores útiles.
Complejidad en optimización de índices y escalabilidad de grandes volúmenes: Requieren algoritmos especializados para mantener la latencia en búsquedas sobre millones de vectores (como el índice ScaNN de Google).
Gestión de la seguridad y privacidad: Almacenar embeddings puede implicar riesgos si contienen información sensible extraíble mediante ingeniería inversa. Es fundamental que las capas de seguridad y cumplimiento sean sólidas, sobre todo en entornos regulados.
Manejo de las “alucinaciones” en IA generativa: Los sistemas generativos pueden cometer errores, pero unirlos a bases de datos vectoriales con una base de conocimiento externa permite controlar mejor la fidelidad y veracidad de los resultados.
Impacto de la inteligencia artificial generativa
La irrupción de modelos generativos avanzados, como los de la familia GPT o los generadores multimodales de texto a imagen, ha incrementado la importancia de las bases de datos vectoriales. Su uso como fuente externa de conocimiento en sistemas RAG (Retrieve-Augmented Generation) permite que chatbots, asistentes virtuales y herramientas de productividad accedan a información precisa y actual sin depender solo de lo que hayan «aprendido» en su entrenamiento original.
Este enfoque aporta control, veracidad y capacidad de actualización a los sistemas de IA generativa, disminuyendo el riesgo de respuestas incorrectas o inventadas. Los desarrolladores pueden conectar los modelos de lenguaje a grandes almacenes de embeddings y mejorar la relevancia y precisión de sus respuestas, clave en sectores como el jurídico, el médico o el financiero.
Ejemplos de proyectos y plataformas de bases de datos vectoriales
IBM apuesta por sistemas que integran IA y procesamiento vectorial, impulsando arquitecturas corporativas interoperables y seguras.
ofrece soluciones orientadas al despliegue sencillo, integración con IA y flexibilidad de gestión, ideales para buscadores, recomendadores y aplicaciones multimodales.
incluye AlloyDB, una base de datos avanzada que combina compatibilidad relacional (PostgreSQL) con índices vectoriales ultrarrápidos mediante ScaNN y soporte para búsquedas híbridas y filtrados en línea.
apuesta por la extensibilidad y flexibilidad de despliegue, facilitando el trabajo en entornos locales, aislados o en la nube según las necesidades de seguridad y cumplimiento de cada organización.
Las bases de datos vectoriales suponen una verdadera revolución en la forma en la que las organizaciones gestionan, buscan y explotan la información en contextos complejos y dinámicos. Su potencial para entender el significado y encontrar similitudes profundas entre datos no estructurados, combinando a la vez filtros precisos, abre la puerta a aplicaciones inteligentes mucho más ricas que las permitidas por las arquitecturas tradicionales. La flexibilidad de despliegue, la capacidad de manejar datos sensibles y la integración con modelos de IA generativa las convierten en una pieza fundamental del nuevo ecosistema de datos empresariales. Tanto si hablamos de buscadores internos, sistemas de recomendación ultra personalizados, asistentes inteligentes o plataformas de cumplimiento regulatorio, las bases de datos vectoriales ofrecen una ventaja competitiva clave y están llamadas a liderar la transformación digital de los próximos años.